前言与致谢
这是一本为操作系统课程编写的教材草稿。它通过剖析一个名为 xv6 的示例内核来讲解操作系统的核心概念。xv6 以 Dennis Ritchie 和 Ken Thompson 的 Unix 第六版(v6)[15] 为蓝本,在结构与风格上大体沿袭 v6,但改用 ANSI C [6] 实现,运行于多核 RISC-V [13] 处理器之上。
阅读本书时应结合 xv6 的源代码一起研读——这一写作方式受 John Lions 的《UNIX 第六版源代码分析》(Commentary on UNIX 6th Edition)[10] 启发。参见 https://pdos.csail.mit.edu/6.S081,该页面提供了关于 v6 与 xv6 的在线资源索引,其中包括若干基于 xv6 的实验作业。
我们已在 MIT 的操作系统课程 6.828 与 6.S081 中使用本教材。我们感谢这些课程的教员、助教与学生们,他们以各种方式直接或间接地为 xv6 作出了贡献。特别感谢 Adam Belay、Austin Clements 和 Nickolai Zeldovich。同时感谢通过邮件向我们指出书中错误或提出改进建议的朋友们:Abutalib Aghayev、Sebastian Boehm、Anton Burtsev、Raphael Carvalho、Tej Chajed、Rasit Eskicioglu、Color Fuzzy、Wojciech Gac、Giuseppe、Tao Guo、Haibo Hao、Muhammed Mourad、Naoki Hayama、Robert Hilderman、Wolfgang Keller、Henry Laih、Jin Li、Austin Liew、Pavan Maddamsetti、Jacek Masiulaniec、Michael McConville、m3hm00d、miguelgvieira、Mark Morrissey、Harry Pan、Askar Safin、Salman Shah、Adeodato Simó、Ruslan Savchenko、Pawel Szczurko、Warren Toomey、tyfkda、tzerbib、Vanush Vaswani、Xi Wang、Sam Whitlock 以及 Zou Chang Wei。
如果您发现书中的错误或有改进建议,请发邮件给 Frans Kaashoek 和 Robert Morris(kaashoek,rtm@csail.mit.edu)。
第 1 章 操作系统接口
操作系统的任务是在多个程序之间共享一台电脑,并提供一组比硬件本身更有用的服务。操作系统管理并抽象底层硬件,例如,文本处理器不必关心使用的是哪种磁盘硬件。操作系统在多个程序之间共享硬件,使它们能够(或者看起来能够)同时运行。最后,操作系统还为程序之间的交互提供受控的方式,使它们可以共享数据或协同工作。
操作系统通过一个接口向用户程序提供服务。设计一个好的接口其实并不容易。一方面,我们希望接口简单且窄,因为这样更容易把实现做正确;另一方面,我们又禁不住想为应用程序提供许多复杂的功能。化解这种张力的诀窍是:设计依赖少数几种机制的接口,并让这些机制可以组合起来,提供很强的通用性。
本书使用一个具体的操作系统作为例子来阐明操作系统的各种概念。这个操作系统就是 xv6,它提供了 Ken Thompson 和 Dennis Ritchie 的 Unix 操作系统所引入的基本接口,并模仿了 Unix 的内部设计。Unix 提供的是一个窄接口,但其机制能够很好地组合,带来出人意料的通用性。这个接口非常成功,以至于现代操作系统——BSD、Linux、macOS、Solaris,甚至在某种程度上包括 Microsoft Windows——都拥有类 Unix 的接口。理解 xv6 是理解这些系统以及许多其他系统的一个良好起点。
如图 1.1 所示,xv6 采用了传统的内核形式:内核是一个特殊的程序,为运行中的程序提供服务。每个运行中的程序称为一个进程(process),它的内存包含指令、数据和一个栈。指令实现程序的计算;数据是计算所操作的变量;栈则组织程序的函数调用。一台电脑通常会有许多个进程,但只有一个内核。
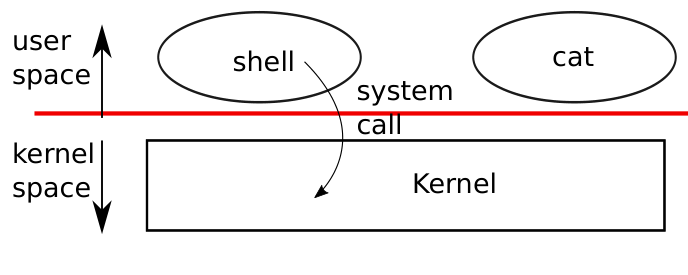
当一个进程需要请求内核的服务时,它会发起一个系统调用,系统调用是操作系统接口中的一类调用。系统调用进入内核;内核执行所请求的服务并返回。因此,进程会在用户空间和内核空间之间交替运行。
内核使用 CPU 提供的硬件保护机制(本书一般用 CPU 一词指代执行运算的硬件部件;其他文档,如 RISC-V 规范,会使用 processor、core 或 hart 等词来代替 CPU),来确保每个在用户空间中运行的进程只能访问它自己的内存。内核以实现这些保护所需的硬件特权运行;用户程序则在没有这些特权的情况下运行。当用户程序发起系统调用时,硬件会提升特权级别,并开始执行内核中预先安排好的函数。
用户程序看到的接口就是内核提供的系统调用的集合。xv6 内核提供了传统 Unix 内核所提供服务与系统调用的一个子集。图 1.2 列出了 xv6 的全部系统调用。
图 1.2 xv6 系统调用(若未特别说明,这些调用无错误时返回 0,出错时返回 -1)
| 系统调用 | 描述 |
|---|---|
int fork() |
创建一个进程,返回子进程的 PID。 |
int exit(int status) |
终止当前进程;状态会报告给 wait()。该调用不返回。 |
int wait(int *status) |
等待一个子进程退出;退出状态写入 *status;返回子进程的 PID。 |
int kill(int pid) |
终止进程 PID。返回 0,出错返回 -1。 |
int getpid() |
返回当前进程的 PID。 |
int sleep(int n) |
暂停 n 个时钟节拍。 |
int exec(char *file, char *argv[]) |
加载一个文件并带参数执行;仅当出错时才返回。 |
char *sbrk(int n) |
将进程的内存增加 n 个字节。返回新内存的起始地址。 |
int open(char *file, int flags) |
打开一个文件;flags 指示读/写;返回一个文件描述符(fd)。 |
int write(int fd, char *buf, int n) |
从 buf 向文件描述符 fd 写入 n 个字节;返回 n。 |
int read(int fd, char *buf, int n) |
从文件描述符 fd 读取 n 个字节到 buf;返回读取的字节数;到达文件结尾时返回 0。 |
int close(int fd) |
释放打开的文件 fd。 |
int dup(int fd) |
返回一个指向与 fd 相同文件的新文件描述符。 |
int pipe(int p[]) |
创建一个管道,读/写文件描述符分别放入 p[0] 和 p[1]。 |
int chdir(char *dir) |
更改当前目录。 |
int mkdir(char *dir) |
创建一个新目录。 |
int mknod(char *file, int, int) |
创建一个设备文件。 |
int fstat(int fd, struct stat *st) |
将一个已打开文件的信息填入 *st。 |
int stat(char *file, struct stat *st) |
将一个具名文件的信息填入 *st。 |
int link(char *file1, char *file2) |
为文件 file1 创建另一个名字(file2)。 |
int unlink(char *file) |
移除一个文件。 |
本章其余部分将概述 xv6 的服务——进程、内存、文件描述符、管道以及文件系统——并用代码片段和讨论来说明 shell(Unix 的命令行用户接口)是如何使用这些服务的。shell 对系统调用的使用说明了这些调用经过了多么精心的设计。
shell 是一个普通的程序,它读取用户输入的命令并执行。shell 是用户程序而不是内核的一部分,这一点凸显了系统调用接口的强大:shell 并没有什么特别之处。这也意味着 shell 很容易被替换;因此,现代 Unix 系统上有各式各样的 shell 可供选择,每种 shell 都有自己的用户界面和脚本功能。xv6 的 shell 是对 Unix Bourne shell 精髓的一个简单实现,其实现可以在 user/sh.c:1 中找到。
1.1 进程与内存
一个 xv6 进程由用户空间中的内存(指令、数据与栈)以及仅内核可见的每进程私有状态组成。xv6 以分时(time-sharing)的方式管理进程:它在等待运行的进程之间透明地切换可用的 CPU。当某个进程没有在运行时,xv6 会保存它的 CPU 寄存器,并在下次运行该进程时恢复它们。内核为每个进程关联一个标识符,即 PID(process identifier,进程标识符)。
一个进程可以通过 fork 系统调用创建一个新的进程。fork 赋予新进程与调用进程完全相同的内存内容(指令和数据都在内)。fork 会在原来的进程和新进程中各返回一次:在原来的进程中,fork 返回新进程的 PID;在新进程中,fork 返回 0。原来的进程和新进程通常分别被称为“父进程”和“子进程”。
举例来说,请看以下这段用 C 语言编写的程序片段:
int pid = fork();
if(pid > 0){
  printf("parent: child=%d\n", pid);
  pid = wait((int *) 0);
  printf("child %d is done\n", pid);
} else if(pid == 0){
  printf("child: exiting\n");
  exit(0);
} else {
  printf("fork error\n");
}
exit 系统调用会使调用它的进程停止执行,并释放内存、已打开文件等资源。exit 接收一个整数状态参数,惯例上 0 表示成功,1 表示失败。wait 系统调用返回当前进程一个已退出(或被终止)的子进程的 PID,并把子进程的退出状态复制到传给 wait 的地址;如果调用者的子进程都还没有退出,wait 就会等待其中一个退出。如果调用者没有子进程,wait 立即返回 -1。如果父进程不关心子进程的退出状态,可以给 wait 传一个 0 地址。
在这个例子中,输出行:
parent: child=1234
child: exiting
可能以任意顺序出现(甚至交错在一起),这取决于父进程和子进程谁先执行到 printf。子进程退出后,父进程的 wait 返回,父进程随之打印出 parent: child 1234 is done。虽然子进程最初拥有与父进程相同的内存内容,但父进程和子进程运行在各自不同的内存和寄存器上:在一个进程中改变变量不会影响另一个。例如,当 wait 的返回值被存入父进程的变量 pid 时,并不会改变子进程中的变量 pid,子进程中 pid 的值仍然是 0。
exec 系统调用用从文件系统中的一个文件加载的新内存映像来替换调用进程的内存。这个文件必须具有特定的格式,指明文件的哪个部分存放指令、哪个部分是数据、从哪条指令开始执行等。xv6 使用 ELF 格式,第 3 章会详细讨论。当 exec 成功时,它不会返回到调用程序;相反,从文件加载的指令会从 ELF header 中声明的入口点开始执行。exec 接收两个参数:一个是包含可执行程序的文件的名称,另一个是字符串参数组成的数组。例如:
char *argv[3];
argv[0] = "echo";
argv[1] = "hello";
argv[2] = 0;
exec("/bin/echo", argv);
printf("exec error\n");
这段代码会用 /bin/echo 程序的一个实例替换当前程序,该实例带着参数列表 echo 和 hello 运行。大多数程序会忽略参数数组的第一个元素,这个元素惯例上是程序本身的名称。
xv6 的 shell 使用上述调用来代表用户运行程序。shell 的整体结构很简单,参见 user/sh.c:145 中的 main。主循环通过 getcmd 从用户那里读取一行输入,然后调用 fork,创建 shell 进程的一个副本。父进程调用 wait,子进程则运行命令。例如,如果用户向 shell 输入了 “echo hello”,那么 runcmd 就会被调用,并以 “echo hello” 作为参数。runcmd(user/sh.c:58)运行实际的命令。对于 “echo hello”,它会调用 exec(user/sh.c:78)。如果 exec 成功,子进程执行的就是 echo 的指令而不是 runcmd 的。之后的某个时刻 echo 会调用 exit,这将使父进程从 main 中的 wait 返回(user/sh.c:145)。
你可能会想,为什么 fork 和 exec 不合并成一个调用;我们后面会看到,shell 正是利用了二者的分离来实现 I/O 重定向。为了避免“创建一个进程副本、然后立即(用 exec)替换掉它”的浪费,操作系统内核会针对这种用例优化 fork 的实现,采用诸如写时复制(copy-on-write)的虚拟内存技术(见第 4.6 节)。
xv6 对大部分用户空间内存的分配是隐式的:fork 分配保存父进程内存副本所需的内存,exec 分配足以容纳可执行文件的内存。一个进程在运行时若需要更多内存(比如用于 malloc),可以调用 sbrk(n) 将其数据内存增加 n 个字节;sbrk 返回新内存的位置。
1.2 I/O 与文件描述符
文件描述符是一个小整数,表示一个由内核管理的、进程可以从中读取或向其写入的对象。进程可以通过打开一个文件、目录或设备,创建一个管道,或复制一个已有的描述符,来获得文件描述符。为简单起见,我们通常把文件描述符指向的对象称为“文件”;文件描述符接口抽象掉了文件、管道和设备之间的差异,使它们看起来都是字节流。我们把输入和输出统称为 I/O。
在 xv6 内核内部,文件描述符被用作每个进程的文件表中的索引,因此每个进程都有一个从 0 开始的私有文件描述符空间。按照惯例,进程从文件描述符 0(标准输入)读取,把输出写到文件描述符 1(标准输出),把错误消息写到文件描述符 2(标准错误)。正如我们将看到的,shell 利用这些惯例来实现 I/O 重定向和管道。shell 确保自己总是打开着这三个文件描述符(user/sh.c:151),默认情况下它们是控制台的文件描述符。
read 和 write 系统调用以文件描述符为名,从打开的文件读取字节或向其写入字节。调用 read(fd, buf, n) 最多从文件描述符 fd 读取 n 个字节,把它们复制到 buf 中,并返回读取的字节数。每个指向文件的文件描述符都关联着一个偏移量(offset)。read 从当前文件偏移处读取数据,然后把偏移量前进实际读取的字节数:后续的 read 将返回第一个 read 所返回字节之后的字节。当没有更多字节可读时,read 返回 0,表示到达文件结尾。
调用 write(fd, buf, n) 把 buf 中的 n 个字节写到文件描述符 fd,并返回写入的字节数。只有发生错误时写入的字节数才会少于 n。与 read 类似,write 在当前文件偏移处写入数据,然后把偏移量前进实际写入的字节数:每次 write 都从上一次结束的地方继续。
以下这段代码(它构成了 cat 程序的核心)把数据从标准输入拷贝到标准输出。如果发生错误,它把一条消息写到标准错误:
char buf[512];
int n;

for(;;){
  n = read(0, buf, sizeof buf);
  if(n == 0)
    break;
  if(n < 0){
    fprintf(2, "read error\n");
    exit(1);
  }
  if(write(1, buf, n) != n){
    fprintf(2, "write error\n");
    exit(1);
  }
}
这段代码片段中值得注意的一点是,cat 并不知道它是在从文件、控制台还是管道读取数据。类似地,cat 也不知道它是在向控制台、文件还是别的什么东西打印。文件描述符的使用,加上“文件描述符 0 是输入、文件描述符 1 是输出”的惯例,让 cat 可以有简单的实现。
close 系统调用释放一个文件描述符,使其可以被之后的 open、pipe 或 dup 系统调用(见下文)重新使用。新分配的文件描述符总是当前进程中编号最小的未使用描述符。
文件描述符与 fork 的交互让 I/O 重定向很容易实现。fork 在拷贝父进程内存的同时也拷贝它的文件描述符表,因此子进程开始时拥有与父进程完全相同的打开文件。系统调用 exec 替换调用进程的内存,但保留其文件表。这一行为允许 shell 通过 fork 子进程、在子进程中重新打开选定的文件描述符、然后调用 exec 运行新程序的方式来实现 I/O 重定向。下面是 shell 为 cat < input.txt 命令所运行的代码的简化版本:
char *argv[2];

argv[0] = "cat";
argv[1] = 0;
if(fork() == 0) {
  close(0);
  open("input.txt", O_RDONLY);
  exec("cat", argv);
}
子进程关闭文件描述符 0 之后,open 一定会把新打开的 input.txt 放在这个文件描述符上:0 是编号最小的可用文件描述符。于是 cat 运行时,文件描述符 0(标准输入)就指向 input.txt。父进程的文件描述符不受这一过程影响,因为该过程只修改子进程的描述符。
xv6 shell 中 I/O 重定向的代码正是这样工作的(user/sh.c:82)。回想一下,在代码的这个位置,shell 已经 fork 出了子 shell,而 runcmd 将调用 exec 加载新程序。
open 的第二个参数是一组以位表示的标志,控制 open 的行为。可能的取值定义在文件控制(fcntl)头文件(kernel/fcntl.h:1-5)中:O_RDONLY、O_WRONLY、O_RDWR、O_CREATE 和 O_TRUNC,它们分别指示 open 以读方式、写方式或读写方式打开文件,在文件不存在时创建它,以及把文件截断为 0 长度。
现在应该清楚为什么 fork 和 exec 是分离的调用会很有用了:在两者之间,shell 有机会重定向子进程的 I/O 而不打扰主 shell 的 I/O 设置。也可以想象一个假想的合并版 forkexec 系统调用,但用这样的调用做 I/O 重定向的种种方案看起来都很别扭:shell 可以在调用 forkexec 之前修改自己的 I/O 设置(然后再撤销这些修改);或者 forkexec 把 I/O 重定向的指示作为参数接收;或者(最不理想的办法)教会每个像 cat 这样的程序自己做 I/O 重定向。
尽管 fork 拷贝了文件描述符表,但每个底层文件的偏移量是在父进程和子进程之间共享的。考虑下面这个例子:
if(fork() == 0) {
  write(1, "hello ", 6);
  exit(0);
} else {
  wait(0);
  write(1, "world\n", 6);
}
在这段代码结束时,与文件描述符 1 相关联的文件中将包含数据 hello world。父进程的 write(多亏了 wait,它只在子进程结束后运行)从子进程 write 结束的地方继续。这一行为有助于让 shell 命令序列产生连续的输出,比如 (echo hello; echo world) >output.txt。
dup 系统调用复制一个已有的文件描述符,返回一个指向同一底层 I/O 对象的新描述符。这两个文件描述符共享一个偏移量,就像被 fork 复制的文件描述符一样。这是把 hello world 写入文件的另一种方式:
fd = dup(1);
write(1, "hello ", 6);
write(fd, "world\n", 6);
如果两个文件描述符是通过一系列 fork 和 dup 调用从同一个原始文件描述符派生出来的,它们就共享偏移量。否则,即使它们来自对同一文件的 open 调用,文件描述符也不共享偏移量。dup 允许 shell 实现这样的命令:ls existing-file non-existing-file > tmp1 2>&1。其中的 2>&1 告诉 shell 给这条命令一个文件描述符 2,它是描述符 1 的副本。既有文件的文件名和不存在的文件的错误消息都会出现在文件 tmp1 中。xv6 的 shell 不支持对错误文件描述符做 I/O 重定向,但现在你知道该如何实现它了。
文件描述符是一个强大的抽象,因为它隐藏了所连接对象的细节:一个向文件描述符 1 写入的进程,可能是在写一个文件、一个像控制台这样的设备,或者一个管道。
1.3 管道
管道是由内核管理的一块小型缓冲区,它以一对文件描述符的形式暴露给进程:一个用于读取,一个用于写入。向管道一端写入的数据可以从管道的另一端读取。管道为进程提供了一种通信方式。
以下示例代码运行 wc 程序,其标准输入连接到管道的读取端:
int p[2];
char *argv[2];

argv[0] = "wc";
argv[1] = 0;

pipe(p);
if(fork() == 0) {
  close(0);
  dup(p[0]);
  close(p[0]);
  close(p[1]);
  exec("/bin/wc", argv);
} else {
  close(p[0]);
  write(p[1], "hello world\n", 12);
  close(p[1]);
}
程序调用 pipe,它会创建一条新管道,并把读取和写入文件描述符记录在数组 p 中。fork 之后,父进程和子进程都有指向该管道的文件描述符。子进程调用 close 和 dup,使文件描述符 0 指向管道的读取端,然后关闭 p 中的文件描述符,再调用 exec 运行 wc。当 wc 从标准输入读取时,它读取的就是管道。父进程关闭管道的读取端,向管道写入数据,然后关闭写入端。
如果没有数据可读,对管道的 read 会等待数据写入,或等待所有指向写入端的文件描述符都被关闭;在后一种情况下,read 会返回 0,就像到达数据文件的结尾一样。read 会阻塞到不可能再有新数据到来为止,这正是上面的子进程在运行 wc 前必须关闭管道写入端的原因之一:如果 wc 的某个文件描述符也指向管道的写入端,wc 就永远看不到文件结尾(EOF)。
xv6 的 shell 以与上述代码类似的方式实现诸如 grep fork sh.c | wc -l 这样的管道命令(user/sh.c:100)。子进程创建一条管道,把管道命令的左端和右端连接起来。然后它为管道的左端调用 fork 和 runcmd,为右端也调用 fork 和 runcmd,并等待两者完成。管道的右端可能是本身又包含管道的命令(例如 a | b | c),这条命令又会 fork 出两个新的子进程(一个给 b,一个给 c)。这样,shell 最终可能创建出一棵进程树:树的叶子节点是命令,内部节点是等待左右子进程完成的进程。
原则上,也可以让内部节点运行管道的左端,但要正确地做到这一点会让实现变得复杂。考虑只做下面这一个修改:修改 sh.c,让内部进程不为 p->left 调用 fork,而是直接运行 runcmd(p->left)。这样一来,例如 echo hi | wc 就不会产生输出,因为当 echo hi 在 runcmd 中退出时,内部进程也随之退出,再也不会调用 fork 去运行管道的右端。这个不正确的行为可以通过让 runcmd 在内部进程中不调用 exit 来修复,但这个修复使代码复杂化了:现在 runcmd 需要知道自己是否运行在内部进程中。不为 runcmd(p->right) 调用 fork 也会引发类似的麻烦。例如,只做这一处修改的话,sleep 10 | echo hi 会立即打印出 “hi” 并给出新的提示符,而不是等到 10 秒之后;这是因为 echo 立即运行并退出,不会等待 sleep 结束。既然 sh.c 的目标是尽可能简单,它就不去尝试避免创建内部进程。
管道看起来并不比临时文件更强大:管道命令:
echo hello world | wc
不用管道也可以用临时文件实现:
echo hello world >/tmp/xyz; wc </tmp/xyz
但在这种情况下,管道相比临时文件至少有四项优势:
- 第一,管道会自动清理自己;而使用文件重定向时,shell 必须小心地在运行结束后删除
/tmp/xyz。 - 第二,管道可以传递任意长度的数据流,而文件重定向要求磁盘上有足够的空闲空间来存储所有数据。
- 第三,管道允许管道中的各个阶段并行执行,而使用文件的方法要求第一个程序必须先结束,第二个程序才能开始。
- 第四,如果要实现进程间通信,管道的阻塞式读写比文件的非阻塞语义更高效。
1.4 文件系统
xv6 文件系统提供数据文件和目录:数据文件的内容是未经解释的字节数组,目录的内容是指向数据文件和其他目录的具名引用。目录构成一棵树,从一个称为根(root)的特殊目录开始。像 /a/b/c 这样的路径指的是根目录 / 中名为 a 的目录中名为 b 的目录中名为 c 的文件或目录。不以 / 开头的路径会相对调用进程的当前目录来求值,当前目录可以用 chdir 系统调用更改。以下两段代码打开的是同一个文件(假设涉及的所有目录都已存在):
chdir("/a");
chdir("b");
open("c", O_RDONLY);

open("/a/b/c", O_RDONLY);
第一段代码把进程的当前目录改为 /a/b;第二段代码既不引用也不改变进程的当前目录。
有一些用来创建新文件和目录的系统调用:mkdir 创建一个新目录,带 O_CREATE 标志的 open 创建一个新的数据文件,mknod 创建一个新的设备文件。下面这个例子展示了三者的用法:
mkdir("/dir");
fd = open("/dir/file", O_CREATE|O_WRONLY);
close(fd);
mknod("/console", 1, 1);
mknod 创建一个引用设备的特殊文件。与设备文件相关联的是主设备号和次设备号(即 mknod 的两个参数),它们唯一地标识一个内核设备。之后进程打开这个设备文件时,内核会把 read 和 write 系统调用转交给内核中的设备实现,而不是交给文件系统。
文件的名称与文件本身是分开的;同一个底层文件(称为 inode)可以拥有多个名称,这些名称称为链接(link)。每个链接由目录中的一个目录项组成,目录项包含一个文件名和一个对 inode 的引用。inode 保存着文件的元数据,包括文件的类型(文件、目录或设备)、长度、文件内容在磁盘上的位置,以及指向该文件的链接数。
fstat 系统调用从文件描述符指向的 inode 中获取信息。它会填充一个 struct stat 结构,该结构在 stat.h(kernel/stat.h)中定义如下:
#define T_DIR     1   // 目录
#define T_FILE    2   // 文件
#define T_DEVICE  3   // 设备

struct stat {
  int dev;     // 文件系统的磁盘设备
  uint ino;    // inode 编号
  short type;  // 文件类型
  short nlink; // 指向该文件的链接数
  uint64 size; // 文件大小(字节)
};
link 系统调用创建另一个文件系统名称,指向与现有文件相同的 inode。以下这段代码创建了一个既名为 a 又名为 b 的新文件:
open("a", O_CREATE|O_WRONLY);
link("a", "b");
此时读取或写入 a 就等同于读取或写入 b。每个 inode 由一个唯一的 inode 编号标识。运行完上面的代码后,可以通过检查 fstat 的结果来确定 a 和 b 指向同一个底层内容:两者会返回相同的 inode 编号(ino),且 nlink 计数会被设置为 2。
unlink 系统调用从文件系统中移除一个名称。只有当文件的链接计数为 0 且没有文件描述符再指向它时,文件的 inode 及其内容所占的磁盘空间才会被释放。因此,在上面的代码后再加上:
unlink("a");
该文件的 inode 和内容仍然可以通过 b 访问。此外,
fd = open("/tmp/xyz", O_CREATE|O_RDWR);
unlink("/tmp/xyz");
是一种创建无名称临时 inode 的惯用法,当进程关闭 fd 或退出时,这个 inode 会被自动清理。
Unix 提供了许多可以从 shell 调用的文件工具,它们是用户级程序,例如 mkdir、ln 和 rm。这种设计允许任何人通过添加新的用户级程序来扩展命令行接口。事后看来这个方案似乎显而易见,但在 Unix 诞生之时,其他系统常常把这样的命令内置到 shell 中(甚至把 shell 内置到内核中)。
一个例外是 cd,它内置在 shell 中(user/sh.c:160)。cd 必须改变 shell 自身的当前工作目录。如果 cd 是作为一条普通命令运行的,那么 shell 就得 fork 一个子进程,子进程运行 cd,而 cd 改变的只是子进程的工作目录。父进程(即 shell)的工作目录则不会改变。
1.5 现实世界
Unix 把“标准”文件描述符、管道以及操作它们的便捷 shell 语法组合在一起,这在编写通用且可复用的程序方面是一项重大进步。这个想法催生了“软件工具”(software tools)文化,这正是 Unix 强大与流行的重要原因之一,而 shell 则是最早的所谓“脚本语言”(scripting language)。Unix 系统调用接口今天仍存在于 BSD、Linux 和 macOS 等系统中。
Unix 系统调用接口已通过可移植操作系统接口(Portable Operating System Interface,POSIX)标准实现了标准化。但 xv6 并不符合 POSIX 规范:它缺少许多系统调用(包括诸如 lseek 这样的基本调用),而且它提供的许多系统调用与标准不一致。我们为 xv6 设定的主要目标是简单和清晰,同时提供一个简单的类 Unix 系统调用接口。一些人已经对 xv6 进行了扩展,添加了更多系统调用和一个简单的 C 库,使其能够运行一些基本的 Unix 程序。然而,现代内核提供的系统调用和内核服务远比 xv6 多,种类也远比 xv6 多。例如,它们支持网络、窗口系统、用户级线程、多种设备的驱动程序等等。现代内核在持续快速地演进,并提供了许多超出 POSIX 的功能。
Unix 用一套统一的文件名和文件描述符接口,实现了对多种类型资源(文件、目录和设备)的访问。这个想法可以扩展到更多种类的资源;一个很好的例子是 Plan 9,它把“资源即文件”的概念应用到了网络、图形等更多领域。不过,大多数源自 Unix 的操作系统并没有走这条路。
文件系统和文件描述符一直是强大的抽象。即便如此,操作系统的接口还有其他模型。Unix 的前身 Multics 以类似内存的方式抽象文件存储,产生了一种风格迥异的接口。Multics 设计的复杂性直接影响了 Unix 的设计者,他们试图构建一个更简单的系统。
xv6 没有提供用户的概念,也没有用户之间的保护机制;用 Unix 的术语来说,所有 xv6 进程都以 root 身份运行。
本书将考察 xv6 如何实现其类 Unix 的接口,但这些思想和概念并不只适用于 Unix。任何操作系统都必须把多个进程多路复用(multiplex)到底层硬件上,将进程彼此隔离,并提供受控的进程间通信机制。在学习完 xv6 之后,你应该能够审视其他更复杂的操作系统,并在其中识别出 xv6 所体现的这些概念。
1.6 练习
- 编写一个程序,使用 UNIX 系统调用,通过一对管道(每个方向一条)在两个进程之间来回“乒乓”(ping-pong)传递一个字节。以每秒交换次数(exchanges per second)为单位,测量这个程序的性能。
第 2 章 操作系统组织
操作系统的一项关键需求是要能够同时支持多个活动,例如,通过第 1 章所描述的系统调用接口,一个进程可以使用 fork 创建新的进程。操作系统还必须在这些进程之间分时共享电脑的资源,例如,即使进程数量超过了硬件 CPU 的数量,操作系统仍必须确保所有进程都能获得运行的机会。操作系统也必须在进程之间安排隔离机制,换句话说,如果某个进程出现错误并发生故障,它不应该影响到那些不依赖它的进程。然而,完全的隔离又过于强硬,因为进程之间应当可以有意地交互,管道就是一个例子。因此,操作系统必须满足三个需求:多路复用(multiplexing)、隔离(isolation)与交互(interaction)。
本章将概述操作系统是如何组织架构以实现这三项需求的。事实上,有许多不同的方式可以达成,但本书聚焦于以单体内核(monolithic kernel)为中心的主流设计,这种设计被许多 Unix 操作系统所采用。本章也会简要说明 xv6 中的进程,它是 xv6 中实现隔离的基本单位,以及 xv6 启动时创建第一个进程的过程。
xv6 运行于一颗多核(multi-core)1 的 RISC-V 微处理器上,其许多底层功能(例如进程的实现)都依赖于 RISC-V 架构。RISC-V 是一种 64 位的 CPU,而 xv6 是使用“LP64”模式的 C 语言编写的,这表示在 C 语言中,long(L)与指针(P)是 64 位,而 int 则是 32 位。本书假设读者已在某类架构上做过一些机器级(machine-level)编程,并会在需要时介绍与 RISC-V 有关的概念。关于 RISC-V,一本有用的参考书是《The RISC-V Reader: An Open Architecture Atlas》;用户级 ISA 文档与特权架构文档则是其官方规格。
在一台完整的电脑中,CPU 周围会有许多辅助硬件,其中大部分以 I/O 接口的形式存在。xv6 是针对 qemu 的 -machine virt 选项仿真的辅助硬件所编写的。这些硬件包括:RAM、一个包含引导代码的 ROM、一条与用户键盘和屏幕相连的串行端口,以及一块用于存储的硬盘。
2.1 抽象物理资源
当人们第一次接触操作系统时,可能会问的第一个问题是:为什么需要操作系统?也就是说,可以将上一章的图 1.2 中的系统调用全部实现成一个函数库,应用程序只要链接该函数库即可。在这样的设计下,每个应用程序甚至可以拥有一套量身打造的函数库。应用程序可以直接与硬件资源交互,并以最适合该应用的方式使用这些资源(例如,达成高效或可预期的性能)。有些为嵌入式设备或实时系统所设计的操作系统就是采用这种方式来组织的。
这种函数库式做法的缺点是,如果有多个应用程序同时运行,那么这些应用程序必须都要是“行为良好(well-behaved)”的。例如,每个应用程序都必须定期主动让出 CPU,让其他应用程序能够运行。这种“协作式(cooperative)”的分时机制,在所有应用程序彼此信任、而且没有错误的情况下也许可以接受。但在现实中,应用程序通常不会彼此信任,而且经常会有错误,因此我们常常需要比协作式更强的隔离机制。
为了达成强隔离,禁止应用程序直接访问敏感的硬件资源,取而代之的是将这些资源抽象成服务。例如,Unix 应用程序与存储设备的交互只能通过文件系统提供的 open、read、write 和 close 等系统调用,而不是直接对硬盘进行读写。这不仅提供了路径名称的便利性,也让操作系统作为该接口的实现者能够管理硬盘。即使隔离不是主要考量,有意交互的程序(或是只是想避免彼此干扰)也会发现文件系统比直接使用硬盘来得更加方便。
类似地,Unix 能够在不同的进程之间透明地切换硬件 CPU,并在需要时保存与还原寄存器状态,使得应用程序无需关心分时的细节。这种透明性让操作系统即使在有些应用程序陷入无穷循环的情况下,仍能实现 CPU 的共享。
另一个例子是,Unix 的进程使用 exec 来创建它们的内存映像,而不是直接操作物理内存。这样一来,操作系统可以决定将进程放置在哪个内存位置;如果内存不足,操作系统甚至可以把进程的一部分数据存放到硬盘上。exec 也让用户能够利用文件系统来方便地存储可运行的程序映像文件。
Unix 进程之间的许多交互形式都是通过文件描述符进行的。文件描述符不仅将许多细节(例如管道或文件中的数据存储位置)抽象化,且其设计方式也简化了进程间的交互。例如,如果管道中的某个应用程序失败,内核会为管道中的下一个进程产生一个文件结束(end-of-file)信号。
图 1.2 所示的系统调用接口经过了精心设计,以同时提供程序开发者的便利性与实现强隔离的可能性。Unix 所采用的这种资源抽象方式并不是唯一的做法,但实践证明它是一种有效的方法。
2.2 用户模式、特权模式与系统调用
强隔离(strong isolation)需要在应用程序与操作系统之间设置一个严格的边界。如果某个应用程序出错,我们不希望其会导致整个操作系统或其他应用程序也发生错误。相反地,操作系统应该能够清除这个失败的应用程序,并继续运行其他应用程序。为了实现强隔离,操作系统使应用程序无法修改(甚至是读取)操作系统的数据结构与指令,并且也无法访问其他进程的内存。
CPU 提供了实现强隔离的硬件支持。例如,RISC-V 拥有三种 CPU 运行指令的模式:机器模式(machine mode)、特权模式(supervisor mode)以及用户模式(user mode)。在机器模式下运行的指令拥有完全的权限,CPU 启动时会从机器模式开始。机器模式主要用于开机时对电脑进行初始化设置,xv6 只会在机器模式运行几行代码,接着就会切换至特权模式。
在特权模式中,CPU 可以运行特权指令,例如开启或关闭中断、读取与写入保存页表地址的寄存器等等。如果某个处于用户模式的应用程序试图运行特权指令,CPU 不会运行该指令,而是会切换至特权模式,让特权模式的代码能够终止该应用程序,因为它做了不该做的事情。
第 1 章中的图 1.1 说明了这种架构,应用程序只能运行用户模式的指令(例如加法等),称为在用户空间(user space)中运行;而特权模式的软件则还能运行特权指令,称为在内核空间(kernel space)中运行。运行于内核空间(或特权模式)的软件被称为内核(kernel)。
应用程序无法直接调用内核函数,若其想要调用某个内核功能(例如 xv6 中的 read 系统调用),则必须转移至内核。CPU 提供了一条特殊的指令,用来将 CPU 从用户模式切换到特权模式,并从由内核指定的进入点进入内核(RISC-V 提供的 ecall 指令就是为此目的而设计的)。
一旦 CPU 切换到特权模式,内核便能验证该系统调用的参数(例如检查传入的内存地址是否属于应用程序的范围),决定应用程序是否有权运行该操作(例如检查应用程序是否有权写入指定文件),然后决定是要拒绝还是运行该请求。由内核控制切换到特权模式的进入点是非常重要的,如果应用程序能够自行决定内核的进入点,恶意应用就可能从绕过参数验证的位置进入内核。
2.3 内核组织
一个关键的设计问题是:操作系统的哪些部分应该在特权模式下运行。其中一种可能的做法是整个操作系统都驻留在内核中,这样所有系统调用的实现都会在特权模式下运行,这种架构被称为单体内核。
在这种架构中,整个操作系统是由一个在拥有完整硬件特权下运行的单一程序所构成。这样的设计相对方便,因为操作系统设计者不需要判断操作系统中哪些部分不需要完整的硬件权限。此外,操作系统的不同组件之间也会更容易合作,例如操作系统可能有一个缓冲区缓存(buffer cache),可供文件系统与虚拟内存系统共用。
单体架构的缺点是:操作系统中不同部分的交互通常很复杂(本书后续会提到),因此操作系统开发者很容易犯错。在单体内核中,错误通常是致命的,因为在特权模式发生错误往往会导致整个内核崩溃。若内核失效,整台电脑就会停止运作,所有应用程序也都会失效,此时就必须重新启动电脑。
为了降低内核错误所带来的风险,操作系统设计者可以尽量减少在特权模式下运行的操作系统代码,并将大部分操作系统的功能放在用户模式运行,这种内核架构被称为微内核(microkernel)。
图 2.1 说明了微内核的设计,在该图中,文件系统是一个以用户级运行的进程。以进程形式运行的操作系统服务被称为服务器(server)。为了让应用程序能够与文件服务器交互,内核提供了一种“进程间通信(inter-process communication)”机制,使得一个用户模式进程可以向另一个进程发送消息。例如,若像 shell 这样的应用程序想读写一个文件,它会发送一个消息给文件服务器并等待回复。
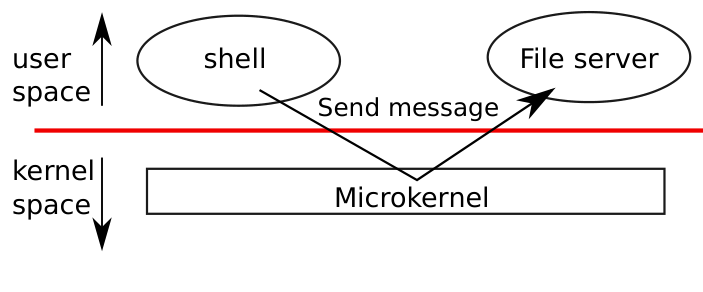
在微内核架构中,内核接口只包含一些低层次的功能,例如启动应用程序、发送消息、访问设备硬件等。这使得内核本身的设计相对简单,因为大部分的操作系统功能都由用户层的服务器来负责。
在现实世界中,单体内核与微内核这两种架构都很流行。许多 Unix 内核采用单体架构,例如 Linux 就是一个单体内核,但其中也有些操作系统功能是以用户层服务器运行的(例如窗口系统)。Linux 能为操作系统密集型的应用提供高性能环境,有部分就是因为内核子系统之间可以紧密集成。
像 Minix、L4 以及 QNX 等操作系统采用了微内核加服务器的架构,并且在嵌入式环境中被广泛使用。L4 的一个变种“seL4”甚至小到足以被形式化验证其内存安全性与其他安全特性[7]。操作系统开发者之间对于哪种架构较佳有许多争论,目前也没有哪一种架构优于另一种的明确证据。此外,这也很取决于“较佳”的定义是什么:更高的性能、更小的代码体积、更可靠的内核、更可靠的整体操作系统(包含用户层服务)等等。
实际上还有一些考量可能比架构选择更重要。有些操作系统采用微内核,但会将部分原本属于用户层的服务放到内核空间中运行,以提高性能。有些操作系统之所以维持单体内核,是因为它们最初就是这样设计的,而将现有系统重写成纯微内核设计所需的代价太高,相较之下添加新功能可能更值得投入。
从本书的观点来看,微内核与单体内核操作系统共享许多关键思想:它们实现系统调用、使用页表、处理中断、支持进程、使用锁来控制并发、实现文件系统等等。本书将聚焦于这些核心思想。
xv6 是以单体内核的方式实现的,与大多数 Unix 操作系统相同。因此,xv6 的内核接口即对应操作系统的接口,且该内核实现了完整的操作系统。虽然 xv6 并未提供太多服务,其内核的规模甚至比某些微内核还小,但在概念上,xv6 属于单体内核。
2.4 代码:xv6 的组织
xv6 的内核源代码位于 kernel/ 子目录中。这些源代码按照一种粗略的模块化概念分为多个文件,图 2.2 列出了这些文件。各模块间的接口定义在 defs.h(kernel/defs.h)中。
图 2.2 xv6 内核源代码文件
| 文件 | 描述 |
|---|---|
| bio.c | 文件系统的磁盘块缓存。 |
| console.c | 连接用户的键盘与屏幕。 |
| entry.S | 最先执行的引导指令。 |
| exec.c | exec() 系统调用。 |
| file.c | 文件描述符支持。 |
| fs.c | 文件系统。 |
| kalloc.c | 物理页分配器。 |
| kernelvec.S | 处理来自内核的陷入和时钟中断。 |
| log.c | 文件系统日志与崩溃恢复。 |
| main.c | 引导期间控制其他模块的初始化。 |
| pipe.c | 管道。 |
| plic.c | RISC-V 中断控制器。 |
| printf.c | 到控制台的格式化输出。 |
| proc.c | 进程与调度。 |
| sleeplock.c | 会让出 CPU 的锁。 |
| spinlock.c | 不会让出 CPU 的锁。 |
| start.c | 早期的机器模式引导代码。 |
| string.c | C 字符串与字节数组库。 |
| swtch.S | 线程切换。 |
| syscall.c | 将系统调用分发到处理函数。 |
| sysfile.c | 与文件相关的系统调用。 |
| sysproc.c | 与进程相关的系统调用。 |
| trampoline.S | 在用户与内核之间切换的汇编代码。 |
| trap.c | 处理陷入与中断并从中返回的 C 代码。 |
| uart.c | 串口控制台设备驱动。 |
| virtio_disk.c | 磁盘设备驱动。 |
| vm.c | 管理页表与地址空间。 |
2.5 进程概览
在 xv6(以及其他 Unix 操作系统)中以“进程”作为隔离的单位。进程这种抽象化可以防止一个进程破坏或窥探其他进程的内存、CPU、文件描述符等资源。它也防止进程破坏内核本身,因此进程无法破坏内核提供的隔离机制。内核在实现进程的抽象化时必须格外谨慎,因为一个有漏洞或恶意的应用程序可能会诱使内核或硬件做出某些不应发生的行为(例如绕过隔离机制)。内核用来实现进程的机制包括:用户模式/特权模式的标志、地址空间(address space),以及线程的时间分配(time-slicing)。
为了加强隔离效果,进程的抽象会给程序一种错觉,好像它拥有一台属于自己的私有机器。进程为程序提供一个看起来是私有的内存系统,也就是地址空间,其他进程无法读写这个空间。进程也让程序感觉它拥有自己的 CPU 来运行其指令。
xv6 使用由硬件实现的页表(page table)来为每个进程提供自己的地址空间。RISC-V 的页表会将虚拟地址(即 RISC-V 指令操作的地址)转换(或称“映射”)为物理地址(也就是 CPU 芯片发送给主内存的地址)。
xv6 为每个进程维护一份独立的页表,来定义该进程的地址空间。如图 2.3 所示,一个地址空间包含该进程的用户内存(user memory),其从虚拟地址 0 开始。最前面是程序的指令,接着是全局变量,然后是栈,最后是用于 malloc 的“堆”(heap),其可视需要扩展。进程地址空间的最大大小受到几个因素的限制:首先 RISC-V 的指针宽度为 64 位,但硬件在查找页表时只使用其中的低 39 位,而 xv6 又只使用了这 39 位中的 38 位,因此最大可用地址为 238 - 1,即 0x3fffffffff,也就是 MAXVA(定义于 kernel/riscv.h:363)。
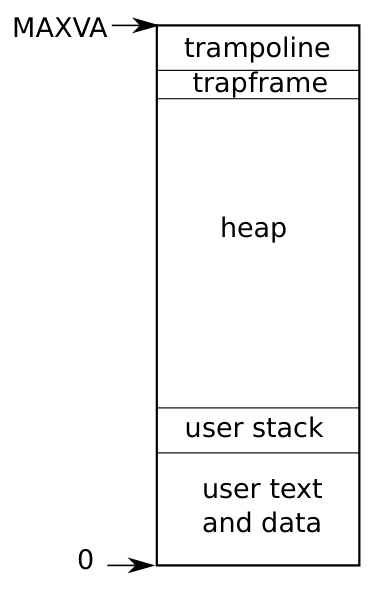
在地址空间的顶端,xv6 保留了一个页(4096 字节)用于 trampoline,以及一个页用于映射该进程的 trapframe。xv6 利用这两个页来实现从用户空间进入内核空间再返回的机制:trampoline 页中含有进出内核所需的代码,而映射 trapframe 则是保存/恢复用户进程状态所必需的,这在第 4 章中会进一步解释。
xv6 的内核为每个进程维护许多状态,这些状态集中存放在 struct proc 结构中(kernel/proc.h:86)。对一个进程来说,最重要的内核状态包含其页表、内核栈,以及运行状态(run state)。本文将使用 p->xxx 的方式来表示 proc 结构中的成员,例如 p->pagetable 表示该进程的页表指针。
每个进程都有一个执行线程(thread,简称线程)来运行该进程的指令。线程可以被暂停,并在稍后恢复。为了让 CPU 能在不同进程之间透明地切换,内核会暂停当前正在运行的线程,并恢复另一个进程中先前已暂停的线程。线程的大部分运行状态(例如局部变量、函数调用的返回地址)会保存在该线程的栈中。
每个进程有两个栈:一个用户栈和一个内核栈(p->kstack)。进程运行用户指令时仅会使用它的用户栈,内核栈是空的。当进程进入内核(例如发出系统调用或中断)时,内核会在该进程的内核栈上运行;而当进程处于内核中时,其用户栈仍保留着数据,但不会被积极使用。进程的线程会在用户栈与内核栈之间交替使用。内核栈是独立且受保护的,因此即使某进程损坏了自己的用户栈,内核仍然能正常运行。
一个进程可以通过运行 RISC-V 的 ecall 指令来发出系统调用。这个指令会提高硬件的权限等级,并将程序计数器设为内核定义的进入点。该进入点的代码会切换至该进程的内核栈,并运行该系统调用的内核代码。当系统调用结束后,内核会切换回用户栈,并通过运行 sret 指令返回用户空间,此指令会降低硬件权限等级,并紧接在系统调用指令之后继续运行用户指令。一个进程的线程可能会在内核中“阻塞”,以等待 I/O 操作完成,而当 I/O 结束后,该线程可以从原先中断的地方继续运行。
p->state 表示该进程的状态,包括是否已分配、是否准备运行、是否正在运行、是否正在等待 I/O,或是否正在退出。p->pagetable 保存该进程的页表,其格式符合 RISC-V 硬件的要求。当 xv6 在用户空间中运行某个进程时,会让分页硬件使用该进程的 p->pagetable。此外,进程的页表也记录了为该进程内存所分配的物理页(page frame)的地址。
总结来说,进程结合了两个设计概念:地址空间,让进程产生拥有独立内存的错觉;以及线程,让进程感觉拥有自己的 CPU。在 xv6 中,一个进程包含一个地址空间与一个线程。而在实际的操作系统中,一个进程可能包含多个线程,以利用多个 CPU 的计算资源。
2.6 代码:启动 xv6——第一个进程与第一个系统调用
为了让 xv6 更具体易懂,我们将简要地说明内核如何启动并运行第一个进程。后续的章节将会更详细地介绍本概要中提到的机制。当 RISC-V 电脑开机时,它会先进行初始化,接着运行存储在只读内存中的引导加载程序(boot loader)。引导加载程序会将 xv6 内核加载到内存中。然后,在机器模式下,CPU 从 _entry(kernel/entry.S:7)开始运行 xv6。此时 RISC-V 的分页硬件尚未激活,因此虚拟地址会直接对应到物理地址。
引导加载程序会将 xv6 内核加载至内存中的物理地址 0x80000000。之所以不是放在 0x0,是因为从 0x0 到 0x80000000 的地址范围内有 I/O 设备。
_entry 内的指令会创建一个栈,让 xv6 能够运行 C 代码。xv6 在 start.c(kernel/start.c:11)中声明了一个初始栈区域 stack0。_entry 的代码会将栈指针(sp)设为 stack0 + 4096,即栈顶,因为在 RISC-V 中栈是向下成长的。现在内核已经有栈了,_entry 会接着调用位于 start(kernel/start.c:21)的 C 函数。
start 函数会进行一些只能在机器模式下完成的设置,然后切换到特权模式。为了进入特权模式,RISC-V 提供了 mret 指令,这个指令通常用来从一个特权模式对机器模式的调用中返回。然而 start 并非是从这类调用返回的,不过它会仿真那种情境:它会在 mstatus 寄存器中将先前权限模式设为特权模式,将 main 的地址写入 mepc 寄存器中作为返回地址,将 satp 设为 0 以停用特权模式下的虚拟地址翻译,并将所有中断与异常委托给特权模式处理。
在进入特权模式之前,start 还要做一件事:设置时钟芯片,使其产生时钟中断。这些收尾工作完成后,start 便会通过调用 mret“返回”到特权模式。这会让程序计数器跳跃到 main(kernel/main.c:11),也就是先前写入 mepc 的地址。
当 main(kernel/main.c:11)初始化完若干设备与子系统后,会通过调用 userinit(kernel/proc.c:226)创建第一个进程。这个第一个进程会运行一段以 RISC-V 汇编语言编写的小程序,并发出 xv6 中的第一个系统调用。initcode.S(user/initcode.S:3)会将 exec 系统调用的编号 SYS_EXEC(kernel/syscall.h:8)加载到寄存器 a7,然后运行 ecall 指令以重新进入内核。
内核会在 syscall(kernel/syscall.c:133)中使用寄存器 a7 内的数值来调用对应的系统调用。系统调用表(kernel/syscall.c:108)会将 SYS_EXEC 映射到函数 sys_exec,接着内核会调用该函数。正如我们在第 1 章中所看到的,exec 会用新的程序(这里是 /init)取代目前进程的内存与寄存器内容。
一旦内核运行完 exec,它会返回到 /init 进程的用户空间。init(user/init.c:15)会在需要时创建一个新的控制台设备文件,然后将其分别以文件描述符 0、1 和 2 打开。接着,它会在控制台上启动一个 shell。此时,系统便已启动完成。
2.7 安全模型
你可能会好奇操作系统会如何处理有缺陷或恶意的代码。由于应对恶意行为比处理意外的程序错误要困难得多,将这一主题归入安全范畴是合理的。接下来我们对操作系统设计中典型的安全假设与目标做一个高层次的概述。
操作系统必须假设某个进程的用户层代码会尽可能地破坏内核或其他进程。用户代码可能会试图对超出其被允许访问的地址空间的指针进行解引用(dereference);可能会尝试运行任何 RISC-V 指令,甚至是那些原本不给用户程序使用的指令;可能会试图读写任何 RISC-V 控制寄存器;可能会直接访问硬件设备;还可能会传递巧妙设计过的值给系统调用,企图诱使内核崩溃或做出愚蠢的行为。内核的目标是限制每个用户进程,使其只能读取、写入、运行它自己的用户内存,只能使用 RISC-V 的 32 个通用寄存器,并且只能通过系统调用所允许的方式来影响内核与其他进程。内核必须防止任何其他行为的发生。这通常是内核设计中绝对必要的要求。
对于内核自身的代码,所抱持的期望则完全不同:内核代码被假设为由善意且谨慎的程序员所编写。因此我们预期内核代码是没有错误的,当然也不会包含任何恶意行为。这个假设会影响我们分析内核代码的方式,例如,有许多内核内部函数(例如自旋锁(spinlock))如果被错误使用会造成严重问题。
在检查任何特定的内核代码时,我们会希望能够确信它的行为是正确的。不过,我们仍假设整体来说内核代码是被正确编写的,并且遵循所有使用内核内部函数与数据结构的规则。在硬件层面上,RISC-V 的 CPU、RAM、硬盘等也被假设会如同其说明文档所述那样正常运作,并且不存在硬件错误。
当然,现实中的情况并不那么单纯。很难防止聪明的用户代码通过消耗内核保护的资源(如磁盘空间、CPU 时间、进程表中的槽位等)使系统变得不可用(或导致系统 panic)。要编写完全无错误的内核代码或设计毫无缺陷的硬件通常是几乎不可能的;如果恶意程序的作者发现了内核或硬件的漏洞,他们就会加以利用。
即使是在像 Linux 这样成熟且被广泛使用的内核中,人们仍不断发现新的安全漏洞。为了应对内核自身可能有错的情况,在内核中设计保护措施是值得的:如断言(assert)、类型检查、栈保护页(stack guard page)等。
最后,用户与内核代码之间的界线有时并不那么清楚:某些具有特权的用户层进程可能会提供重要服务,因此其实际上也会成为操作系统的一部分;而在某些操作系统中,特权用户程序甚至可以将新的代码插入内核(例如 Linux 的可加载内核模块机制)。
2.8 现实世界
大多数操作系统都采用了进程的概念,而大多数进程的样貌也与 xv6 的类似。然而,现代操作系统会支持一个进程内有多个线程,以便让单个进程能利用多个 CPU。在一个进程内支持多线程需要相当多的机制,而 xv6 并不具备这些,其中通常也包括一些接口上的变动(例如 Linux 的 clone,它是 fork 的一种变体),用以控制线程之间共享进程的哪些部分。
2.9 练习
- 为 xv6 添加一个系统调用,返回当前可用的空闲内存总量。
-
本文所称“多核”(multi-core)指多个共享内存但并行执行的 CPU,每个都拥有自己的一组寄存器。本文有时用多处理器(multiprocessor)一词作为 multi-core 的同义词,不过 multiprocessor 也可以更具体地指由多个独立处理器芯片组成的计算机。 ↩
第 3 章 页表
页表是操作系统用来为每个进程提供私有地址空间与内存的最常见的机制。页表决定了内存地址的含义,以及哪些物理内存区段可以被访问。它们让 xv6 能够隔离不同进程的地址空间,并把它们多路复用到同一块物理内存上。
页表之所以被广泛使用,是因为它们提供了一层间接性,使操作系统能够应用许多“技巧”。xv6 就用到了其中几个技巧:将相同的内存(例如 trampoline 页)映射到多个地址空间中,以及用一个未映射的页来保护内核栈与用户栈。接下来的章节会说明 RISC-V 硬件所提供的页表功能,以及 xv6 是如何使用这些功能的。
3.1 分页硬件
回顾一下,RISC-V 的指令(无论是用户还是内核的)操作的都是虚拟地址。机器的 RAM,也就是物理内存,是以物理地址来索引的。RISC-V 的分页硬件会将这两类地址连接起来,把每个虚拟地址映射到一个物理地址。
xv6 运行在 Sv39 的 RISC-V 上,这意味着 64 位虚拟地址中只有最低的 39 位会被使用,最高的 25 位不会被使用。在这种 Sv39 配置下,一个 RISC-V 页表在逻辑上是一个包含 227(134,217,728)个页表项(PTE)的数组。每个 PTE 包含一个 44 位的物理页号(PPN)以及一些标志。分页硬件翻译一个虚拟地址时,会用 39 位中最高的 27 位去索引页表,找到对应的 PTE,然后拼出一个 56 位的物理地址:高 44 位来自 PTE 里的 PPN,低 12 位则直接拷贝自原本虚拟地址中的低 12 位。图 3.1 用一种把页表简化为 PTE 数组的逻辑视图展示了这个过程(更完整的结构请见图 3.2)。页表让操作系统可以用 4096(212)字节对齐的区块为单位,控制虚拟地址到物理地址的对应关系。这样的区块就称为一个页(page)。
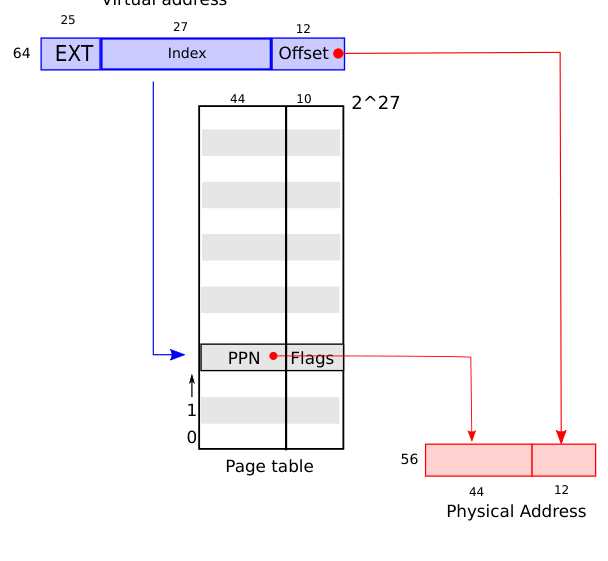
在 Sv39 的 RISC-V 中,虚拟地址的最高 25 位并不会参与翻译。物理地址方面也为增长预留了空间:在 PTE 的格式中,PPN 还可以再增加 10 位。RISC-V 的设计者是根据技术的发展预测来选定这些数值的。239 字节等于 512 GB,对于在 RISC-V 电脑上运行的应用程序来说应该已经足够。256 则提供了足够的物理内存空间,在可见的未来能容纳许多 I/O 设备与 DRAM 芯片。如果未来还需要更多,RISC-V 的设计者也已经定义了拥有 48 位虚拟地址的 Sv48[1]。
如图 3.2 所示,RISC-V 的 CPU 会通过三个步骤将虚拟地址转换为物理地址。页表在物理内存中会以一棵三层树的形式保存,这棵树的根是一个 4096 字节的页表页,里面包含 512 个 PTE,这些 PTE 中保存着下一层页表页的物理地址。而下一层的每个页表页中,又包含 512 个树中最底层使用的 PTE。
分页硬件会使用 27 位中最高的 9 位在根页表页中选取一个 PTE,用中间的 9 位在下一层的页表页中选取一个 PTE,而用最低的 9 位来选取最终的 PTE。(在 Sv48 的 RISC-V 中,页表有四层,虚拟地址的第 39 到 47 位会用来索引最顶层。)
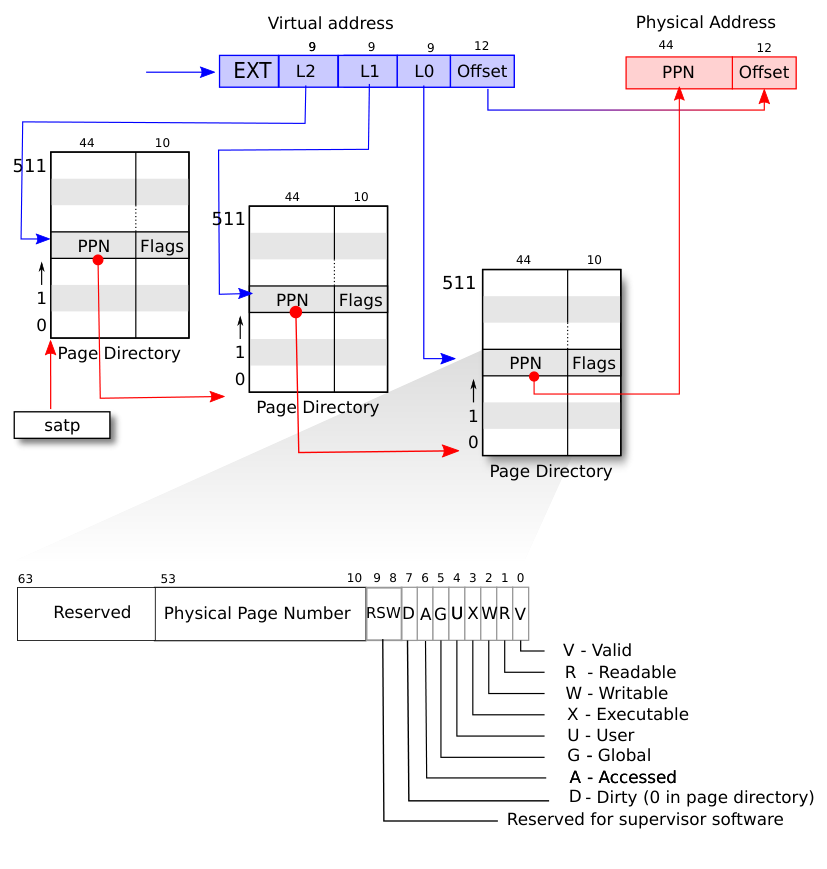
如果在地址翻译所需的三个 PTE 中有任何一个不存在,分页硬件就会产生缺页异常,并交由内核来处理这个异常(详见第 4 章)。
相较于图 3.1 的单层设计,图 3.2 所示的三层结构提供了一种更节省内存的方式来记录 PTE。在大片虚拟地址范围根本没有被映射这种常见情况下,三层结构有机会直接省略整个页目录。例如,如果一个应用程序只使用从地址 0 开始的几个页,那么顶层页目录中第 1 到 511 项都会是无效的,内核不必耗费页来存放这 511 个中间层页目录;而且它也不需要为这 511 个中间层页目录所对应的底层页目录分配页。因此,在这个例子中,三层结构可以节省 511 个中间层页目录的页,以及 511×512 个底层页目录的页。
虽然 CPU 会在执行 load 或 store 指令时,由硬件自动走访这个三层结构,但三层结构有个潜在缺点:CPU 必须从内存中加载三个 PTE,才能完成 load/store 指令中虚拟地址到物理地址的转换。为了减去从物理内存加载 PTE 的开销,RISC-V 的 CPU 会将 PTE 缓存在一个称为 Translation Look-aside Buffer(TLB)的结构中。
每个 PTE 都包含一些标志位,用来告诉分页硬件这个相关联的虚拟地址允许被如何使用。PTE_V 表示这个 PTE 是否存在:如果它没被设置,对该页的引用就会引发异常(也就是不被允许)。PTE_R 决定指令能否从该页读取。PTE_W 决定指令能否写入该页。PTE_X 决定 CPU 是否可以将该页的内容作为指令来解释并执行。PTE_U 决定用户模式下的指令是否可以访问该页;如果没设置 PTE_U,则仅能在特权模式中使用该 PTE。图 3.2 展示了这一切是如何运作的。这些标志以及其他所有与分页硬件相关的结构都定义在 kernel/riscv.h 中。
若要让硬件使用某个页表,内核必须将根页表页的物理地址写入 satp 寄存器。每颗 CPU 都有自己的 satp,CPU 会使用自己的 satp 所指向的页表,来翻译后续所有指令产生的地址。每颗 CPU 都有自己的 satp,这样不同的 CPU 就可以同时运行不同的进程,各自使用由自己的页表描述的私有地址空间。
内核通常会把所有物理内存都映射进自己的页表,以便能够用 load/store 指令读写物理内存中的任何位置。由于页目录就在物理内存中,内核可以用一条标准的 store 指令写入某个 PTE 的虚拟地址,来设置页目录中该 PTE 的内容。
这里对书中所使用的一些术语做个简要说明。物理内存是指 DRAM 中的存储单元。物理内存中的一个字节有一个地址,称为物理地址。指令只使用虚拟地址,这些虚拟地址会先由分页硬件翻译成物理地址,再送到 DRAM 硬件去读写存储。与物理内存和虚拟地址不同,虚拟内存并不是一个物理对象,而是指内核为管理物理内存与虚拟地址所提供的那一组抽象与机制。
3.2 内核地址空间
xv6 为每个进程维护一个页表,用来描述该进程的用户地址空间,此外还有一份单独的全局页表,描述内核的地址空间。内核会配置自己地址空间的布局,使其能够在可预期的虚拟地址上访问物理内存与各种硬件资源。图 3.3 显示了这个布局如何将内核虚拟地址对应到物理地址。kernel/memlayout.h 中声明了 xv6 内核内存布局的各种常数。
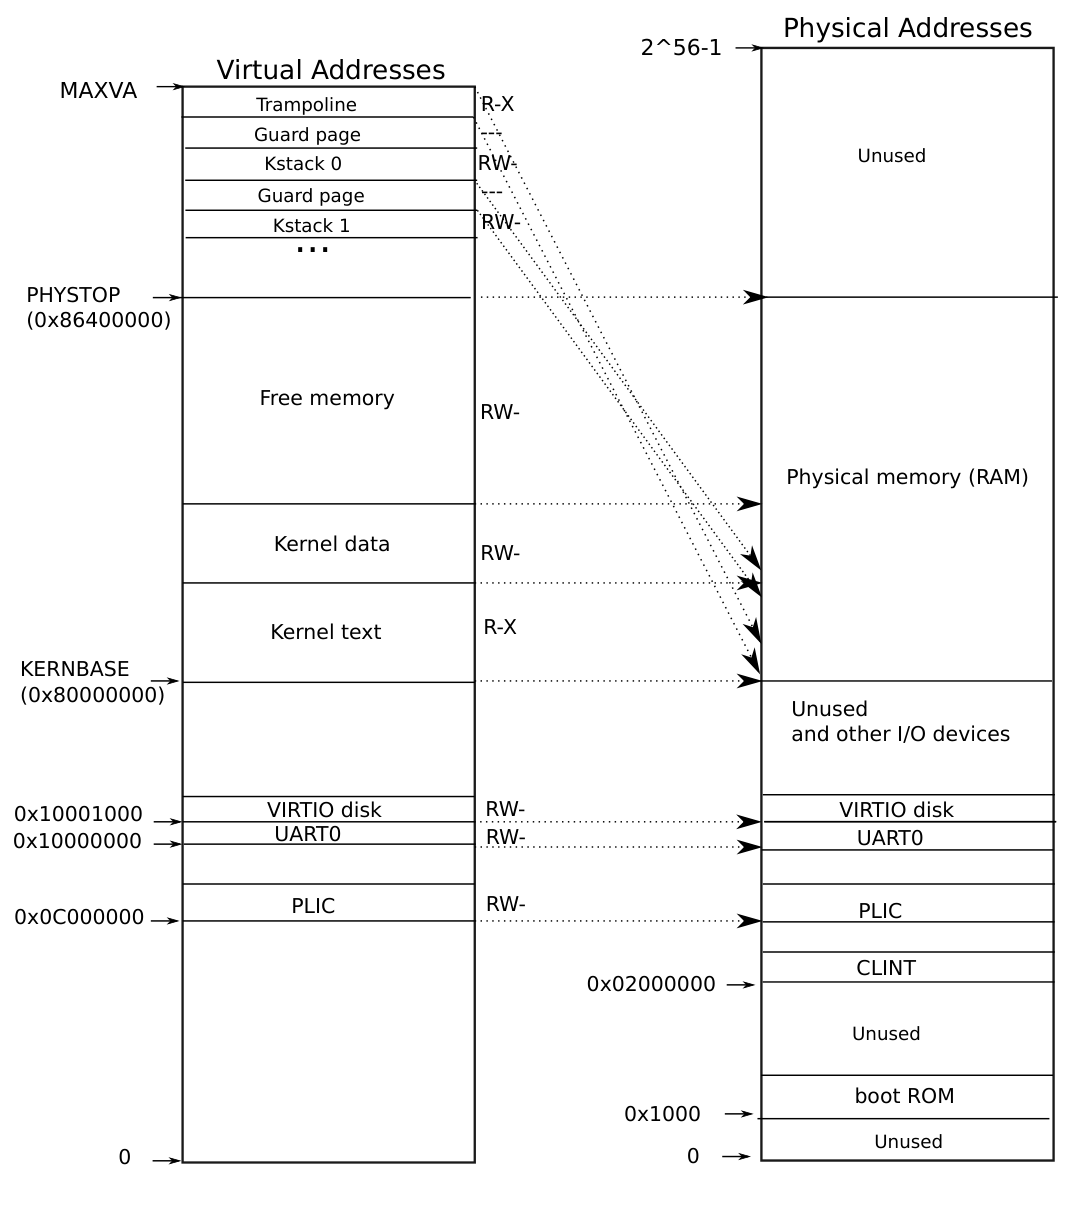
QEMU 模拟了一台电脑,其中的 RAM(物理内存)从物理地址 0x80000000 开始,至少持续到 0x86400000,这段范围在 xv6 中称为 PHYSTOP。QEMU 的模拟还包含磁盘接口等 I/O 设备,QEMU 以内存映射控制寄存器(memory-mapped control registers)的方式,将这些设备的接口暴露给软件,这些寄存器位于物理地址空间中小于 0x80000000 的位置。内核可以通过读写这些特殊的物理地址与设备交互;换句话说,这些读写是与设备硬件沟通,而不是与 RAM 交互。第 4 章会解释 xv6 是如何与设备交互的。
内核通过“直接映射(direct mapping)”的方式来访问 RAM 与内存映射的设备寄存器,也就是把资源映射到与其物理地址相同的虚拟地址上(VA == PA)。例如,内核本身在虚拟地址空间与物理内存中都位于 KERNBASE=0x80000000。直接映射能简化内核中读写物理内存的代码。例如,当 fork 为子进程分配用户内存时,分配器会返回那块内存的物理地址;fork 在拷贝父进程的用户内存到子进程时,会直接把这个物理地址当作虚拟地址使用。
有几个内核虚拟地址并不是直接映射的:
- trampoline 页。它被映射在虚拟地址空间的最顶部,用户的页表也会有这个相同的映射。第 4 章会讨论 trampoline 页的用途,但在这里我们可以看到一个有趣的页表用法:同一个物理页(存放 trampoline 代码)在内核的虚拟地址空间中被映射了两次,一次在虚拟地址空间顶部,另一次则是直接映射。
- 内核栈页。每个进程都有自己的内核栈,它会被映射在较高的虚拟地址处,这样 xv6 就能在其下方留出一个没有被映射的保护页(guard page)。保护页的 PTE 是无效的(也就是
PTE_V没有设置),因此当内核栈溢出时,通常就会触发异常并使内核 panic。若没有保护页,栈溢出就可能会覆盖其他内核内存,导致错误行为;而比起悄无声息地出错运行,panic 崩溃是可取的结果。
虽然内核通过高地址映射来使用它的栈,但这些栈其实也可以通过直接映射的地址被内核访问。另一种设计可能只提供直接映射,直接在直接映射的地址上操作栈。不过在这种安排下,如果要提供保护页,就得取消映射那些本来会指向物理内存的虚拟地址,这些物理内存就会变得难以使用。
内核将 trampoline 页与内核代码页设置为具有 PTE_R 与 PTE_X 权限,内核可以在这些页上读取并执行指令。其他页则被设置为具有 PTE_R 与 PTE_W 权限,以便内核能够对这些页进行读写。至于保护页,其映射是无效的。
3.3 代码:创建地址空间
xv6 中大多数负责操作地址空间与页表的代码都写在 vm.c(kernel/vm.c:1)中。核心的数据结构是 pagetable_t,它实际上是一个指向 RISC-V 根页表页的指针;一个 pagetable_t 可能是内核的页表,也可能是某个进程的页表。核心函数是 walk 与 mappages,前者用来找出某个虚拟地址对应的 PTE,后者会为新映射安装 PTE。以 kvm 开头的函数会操作内核的页表;以 uvm 开头的函数会操作用户页表;其他函数则两者通用。copyout 与 copyin 用于从系统调用参数提供的用户虚拟地址中拷贝数据进出;它们写在 vm.c 中,是因为它们必须显式地将这些地址翻译成对应的物理内存。
在开机流程的早期,main 会调用 kvminit(kernel/vm.c:54),通过 kvmmake(kernel/vm.c:20)创建内核的页表。这个调用发生在 xv6 尚未启用 RISC-V 的分页功能之前,因此当时的地址仍直接对应物理内存。kvmmake 会先分配一个物理页作为根页表页,接着调用 kvmmap 来安装内核所需的映射。这些映射包含内核的指令与数据、直到 PHYSTOP 的物理内存,以及实际上是设备的某些内存区段。proc_mapstacks(kernel/proc.c:33)为每个进程分配一个内核栈。它会调用 kvmmap,把每个栈映射到由 KSTACK 生成的虚拟地址上,同时为无效的栈保护页留出空间。
kvmmap(kernel/vm.c:127)会调用 mappages(kernel/vm.c:138),后者为一个虚拟地址范围到对应的物理地址范围安装映射。它按页为间隔,为范围内的每个虚拟地址分别建立映射。对于每个要映射的虚拟地址,mappages 会调用 walk 找到该地址对应 PTE 的地址,然后初始化这个 PTE,填入相应的物理页号、所需的访问权限(PTE_W、PTE_X 和/或 PTE_R),并设置 PTE_V 将该 PTE 标记为有效(kernel/vm.c:153)。
walk(kernel/vm.c:81)模仿 RISC-V 分页硬件查找某个虚拟地址对应 PTE 的行为(见图 3.2)。walk 沿三层页表每次下降 9 位,并使用每一层的 9 位虚拟地址来找到下一层页表或最终页的 PTE(kernel/vm.c:87)。如果 PTE 无效,表示所需的页尚未分配;如果设置了 alloc 参数,walk 就会分配一个新的页表页,并把它的物理地址写入该 PTE。最终 walk 会返回树中最底层那个 PTE 的地址(kernel/vm.c:97)。
上述代码依赖于物理内存已被直接映射进内核的虚拟地址空间。例如,当 walk 沿页表的各层下降时,它会从某个 PTE 中取出下一层页表的(物理)地址(kernel/vm.c:89),然后把这个地址当作虚拟地址,来获取下一层的 PTE(kernel/vm.c:87)。
main 会调用 kvminithart(kernel/vm.c:62)来加载内核的页表。这个函数会将根页表页的物理地址写入寄存器 satp,之后 CPU 就会开始使用这份内核的页表来进行地址翻译。由于内核使用的是恒等映射,下一条指令此时的虚拟地址将会正确地映射到对应的物理内存地址。
每颗 RISC-V CPU 都会将 PTE 缓存在 TLB(Translation Look-aside Buffer)中,而当 xv6 修改页表时,它必须通知 CPU 将对应的 TLB 缓存项作废。否则,之后 TLB 可能会使用过时的缓存映射,指向一个在此期间已被分配给其他进程的物理页,导致某个进程不小心写入其他进程的内存。RISC-V 提供一条名为 sfence.vma 的指令,用于刷新当前 CPU 的 TLB。xv6 会在 kvminithart 中重新加载 satp 寄存器后执行 sfence.vma,也会在切换到用户页表的 trampoline 代码中、返回用户空间之前执行 sfence.vma(kernel/trampoline.S:79)。
为了避免刷新整个 TLB,RISC-V CPU 可能会支持地址空间标识符(ASID)[1]。这样内核就可以只刷新属于特定地址空间的 TLB 缓存项。
3.4 物理内存分配
内核在运行期间必须为页表、用户内存、内核栈以及管道缓冲区分配与释放物理内存。
xv6 使用内核结束地址到 PHYSTOP 之间的物理内存区域作为运行期间的分配来源,一次分配与释放一整个 4096 字节的页。它通过把这些页本身串成一条链表来追踪哪些页是空闲的:分配就是从链表上取出一个页,而释放则是将该页加入链表。
3.5 代码:物理内存分配器
内存分配器实现在 kalloc.c(kernel/kalloc.c:1)中。分配器的数据结构是一条由可供分配的物理内存页组成的空闲链表,每个空闲页的链表元素是一个 struct run(kernel/kalloc.c:17),对应一个空闲页。分配器从哪里取得存放这个数据结构的内存呢?由于空闲页里没有存放别的东西,分配器就把每个空闲页对应的 run 结构直接存在该空闲页里面。这条空闲链表还受到一把自旋锁的保护(kernel/kalloc.c:21-24),链表和锁一起被包在一个结构体中,以明确表示这把锁保护的是该结构体内的字段。目前可以先忽略锁以及 acquire 和 release 的调用,第 6 章会详细讨论加锁。
main 函数会调用 kinit 来初始化分配器(kernel/kalloc.c:27),它会把空闲链表初始化为包含“内核末尾到 PHYSTOP 之间”的每一个页。理论上 xv6 应该要通过解析硬件提供的配置信息来判断可用的物理内存大小,但 xv6 直接假设机器拥有 128 MB 的 RAM。kinit 会调用 freerange,通过逐页调用 kfree 把内存加入空闲链表。
由于 PTE 只能指向对齐到 4096 字节(即 4096 的倍数)的物理地址,freerange 使用 PGROUNDUP 来确保只释放对齐的物理地址。分配器一开始没有任何可用的内存,这些对 kfree 的调用为它提供了可以管理的内存。
分配器有时会将地址当作整数使用,以便对它们进行算术运算(例如在 freerange 中走访所有页),有时又会将地址当作指针使用,用来读写内存(例如操作保存在各页中的 run 结构);这种“地址的双重用途”是分配器实现中充满 C 类型转换的主要原因。另一个原因是,释放与分配本身就会改变内存的类型。
kfree(kernel/kalloc.c:47)会先把要释放的内存中的每个字节都设为数值 1。这样一来,若有程序在释放后仍使用这块内存(即使用“悬空引用(dangling reference)”),它读到的也会是垃圾数据而不是原来的有效内容;希望这能让这类代码更快地暴露故障。接下来,kfree 会将该页加入空闲链表的前端:它将物理地址(pa)强制转换为指向 struct run 的指针,把原来空闲链表的开头记录在 r->next 中,然后再将空闲链表的开头设为 r。kalloc 则从空闲链表中取出并返回第一个元素。
3.6 进程地址空间
每个进程都有自己的页表,而当 xv6 在进程之间切换时,也会随之切换页表。如图 2.3 所示,进程的用户内存从虚拟地址 0 开始,可以一直增长到 MAXVA(kernel/riscv.h:360),这使得一个进程原则上能够寻址高达 256 GB 的内存。
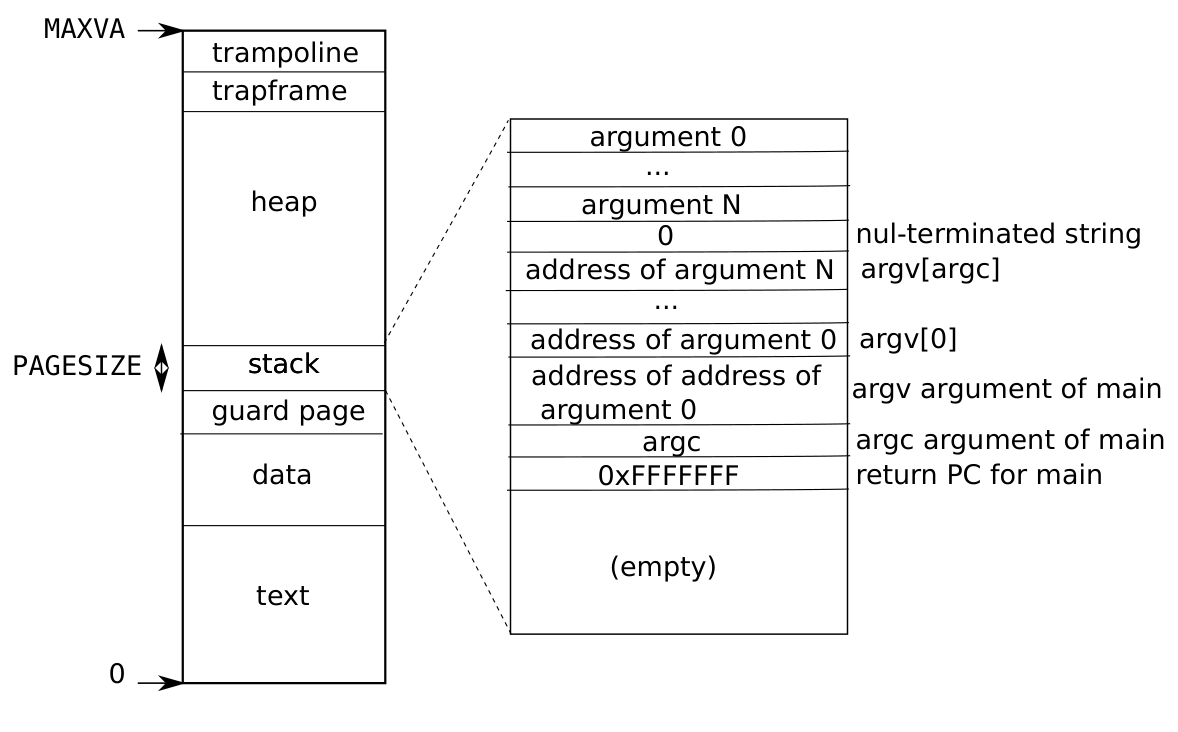
当某个进程向 xv6 请求更多用户内存时,xv6 会首先使用 kalloc 分配物理页,然后在进程的页表中添加指向这些新物理页的 PTE。xv6 会在这些 PTE 中设置 PTE_W、PTE_X、PTE_R、PTE_U 和 PTE_V 标志。大多数进程并不会使用整个用户地址空间;对于未使用的 PTE,xv6 会让 PTE_V 保持未设置。
这里我们能看到几个使用页表的好范例。首先,不同进程的页表会把用户地址翻译成不同的物理内存页,因此每个进程拥有各自私有的用户内存。其次,每个进程看到的自己的内存都是某个从 0 开始且连续排列的虚拟地址空间,而它的物理内存可以是不连续的。第三,内核会在用户地址空间顶端映射一个包含 trampoline 代码的页,因此同一个物理页会出现在所有进程的地址空间中。
图 3.4 更详细地展示了 xv6 中一个正在运行的进程的用户内存布局。栈只占用一个页,图中显示的是由 exec 创建的初始内容。包含命令行参数的字符串,以及指向这些字符串的指针数组,会被放在栈的最顶部。紧接着在其之下的,是一些使程序能够像是刚刚调用了 main(argc, argv) 一样从 main 开始运行的数值。
为了检测用户栈溢出已分配的栈内存,xv6 通过清除 PTE 的 PTE_U 标志,在栈的正下方放置了一个不可访问的保护页。若用户栈溢出并试图使用栈下方的地址,由于该保护页对运行在用户模式的程序是不可访问的,硬件就会产生缺页异常。现实中的操作系统则可能会选择在用户栈溢出时自动分配更多内存。
3.7 代码:sbrk
sbrk 是一个让进程可以扩增或缩减其内存空间的系统调用,这个系统调用是由 growproc(kernel/proc.c:253)函数实现的。growproc 会根据其参数 n 的正负,来调用 uvmalloc 或 uvmdealloc。uvmalloc(kernel/vm.c:221)会使用 kalloc 分配物理内存,并通过 mappages 将 PTE 加入用户的页表。uvmdealloc 则会调用 uvmunmap(kernel/vm.c:166),该函数会使用 walk 寻找 PTE,并通过 kfree 释放它们所指向的物理内存。
xv6 为每个进程建立页表,不仅仅是为了告诉硬件如何将用户虚拟地址映射到物理内存,同时也作为唯一的凭据,记录哪些物理内存页被分配给了该进程。这就是为什么在释放用户内存时(如在 uvmunmap 中),必须检查该进程的页表。
3.8 代码:exec
exec 是创建地址空间用户部分的系统调用,它用文件系统中保存的一个文件来初始化地址空间的用户部分。exec(kernel/exec.c:13)会使用 namei(kernel/exec.c:26)打开指定路径 path 所对应的二进制文件,namei 的细节会在第 8 章中说明。接着它会读取 ELF 头。xv6 应用以广泛使用的 ELF 格式描述,该格式定义于 kernel/elf.h。一个 ELF 格式的文件由一个 ELF 头 struct elfhdr(kernel/elf.h:6)和紧随其后的一连串程序段头 struct proghdr(kernel/elf.h:25)组成。每个 proghdr 描述一个必须被加载到内存中的应用程序区段;xv6 的程序只有一个程序段头,但其他系统可能会为指令和数据设置各自独立的段。
第一步是快速检查该文件是否可能是一个 ELF 二进制文件。ELF 文件的开头会包含 4 字节的“魔数”(magic number):0x7F、'E'、'L'、'F',即 ELF_MAGIC(kernel/elf.h:3)。如果 ELF 头的魔数正确,exec 就会假定这个二进制文件格式正确无误。
exec 会通过 proc_pagetable(kernel/exec.c:38)创建一个不含任何用户映射的新页表,并通过 uvmalloc(kernel/exec.c:52)为每个 ELF 段分配内存,再用 loadseg(kernel/exec.c:10)将每个段加载到内存中。loadseg 会使用 walkaddr 来找到为 ELF 段的每个页要写入的已分配内存的物理地址,并使用 readi 从文件中读取数据。
/init 是第一个使用 exec 创建的用户程序,它的程序段头如下:
# objdump -p _init
user/_init:     file format elf64-littleriscv

Program Header:
    LOAD off    0x00000000000000b0 vaddr 0x0000000000000000
                                     paddr 0x0000000000000000 align 2**3
         filesz 0x0000000000000840 memsz 0x0000000000000858 flags rwx

    STACK off    0x0000000000000000 vaddr 0x0000000000000000
                                     paddr 0x0000000000000000 align 2**4
         filesz 0x0000000000000000 memsz 0x0000000000000000 flags rw-
程序段头的 filesz 可能会小于 memsz,表示两者之间的差额应当用零填满(例如用于 C 的全局变量),而不是从文件中读取数据。对 /init 来说,filesz 为 2112 字节,而 memsz 为 2136 字节,因此 uvmalloc 会分配足以容纳 2136 字节的物理内存,但只从 /init 文件中读取 2112 字节的数据。
现在 exec 分配并初始化用户栈。它只分配一个栈页。exec 将每个参数字符串依次拷贝到栈顶,并把指向它们的指针记录在 ustack 中。它会在即将传给 main 的 argv 列表末端放上一个 null 指针。ustack 的前三项分别是伪造的返回程序计数器、argc 和 argv 指针。
exec 会在栈页的下方放置一个不可访问的页,这样若有程序试图使用超过一个页的栈时就会产生异常。这个不可访问的页也让 exec 能够处理参数过大的情况;若发生这种情形,exec 用来把参数拷贝到栈上的 copyout(kernel/vm.c:347)函数会在拷贝时发现目标页不可访问,然后返回 -1。
在准备新的内存映像的过程中,如果 exec 检测到错误(例如无效的程序段),它会跳转到 bad 标签,释放新创建的映像,并返回 -1。exec 必须等到确定这次系统调用会成功时,才释放旧有的映像:因为若旧映像已经被释放,系统调用就无法再向它返回 -1。exec 中所有的错误情况都只发生在创建新映像的过程中。一旦映像构建完成,exec 就可以提交新的页表(kernel/exec.c:113)并释放旧的页表(kernel/exec.c:117)了。
exec 会将 ELF 文件中的字节按其指定的地址加载到内存中。由于用户或进程可以在 ELF 文件中放入任意想要的地址,因此 exec 存在风险:ELF 文件中的地址可能会指向内核区域,无论是意外还是恶意行为。对于不设防的内核来说,其后果从系统崩溃到内核隔离机制被恶意破坏(即安全漏洞)都有可能发生。xv6 执行了若干检查来规避这些风险。例如,if(ph.vaddr + ph.memsz < ph.vaddr) 用来检查二者相加时是否发生 64 位整数溢出。危险在于:用户可以构造一个 ELF 文件,让 ph.vaddr 指向用户选定的地址,并使 ph.memsz 足够大,让相加结果溢出成 0x1000 这样看似合理的值。
在旧版的 xv6 中,用户地址空间也包含了内核(虽然在用户模式中无法读写),用户可以选择一个对应到内核内存的地址,这样 ELF 文件中的数据就会被拷贝进内核。这在 RISC-V 版本的 xv6 中不会发生,因为内核拥有独立的页表;loadseg 会将数据加载到进程的页表,而不是内核的页表。
对内核开发者来说,很容易遗漏关键的检查。实际上在现实内核的发展历史中,常常会因为缺失某些检查而让用户程序得以利用漏洞获取内核特权。xv6 很可能也没有完全验证由用户层提供给内核的数据,这可能会被恶意用户程序加以利用,来绕过 xv6 的隔离机制。
3.9 现实世界
和大多数操作系统一样,xv6 使用分页硬件来进行内存保护与映射。大多数操作系统通过把分页与缺页异常结合起来,对分页的运用比 xv6 精妙得多,这部分我们将在第 4 章中讨论。
内核直接使用虚拟地址与物理地址的一对一映射,并假设物理 RAM 位于 0x80000000 这个地址——也就是内核预期被加载的位置——这简化了 xv6 的实现。这在 QEMU 上可以正常运作,但在真实硬件上则是个坏主意,因为真实硬件的 RAM 与设备会被安排在不可预测的物理地址上,例如在某些系统中,xv6 预期存放内核的 0x80000000 处可能根本没有 RAM。更严谨的内核设计会利用页表把任意的硬件物理内存布局变成可预期的内核虚拟地址布局。
RISC-V 支持物理地址层面的保护功能,但 xv6 并未使用这项功能。
在拥有大量内存的机器上,使用 RISC-V 所支持的“超级页(super page)”是合理的。当物理内存很小时,使用小页更合理,这样可以以很细的粒度进行分配和换出到磁盘。例如,如果一个程序只用到 8 KB 内存,却给它一整个 4 MB 的超级页,那就很浪费。在具备大量 RAM 的机器上,使用大页更合理,还可以减少页表操作的开销。
xv6 内核缺少类似 malloc 的分配器来为小型对象提供内存,这使得内核无法使用需要动态分配的复杂数据结构。
内存分配是一个经久不衰的热门议题,其基本问题是如何有效利用有限的内存,并为未来不可预期的请求做准备[8]。如今人们更在意分配速度,而非空间效率。此外,更精细的内核很可能会分配许多不同大小的小区块,而不只是像 xv6 一样仅使用 4096 字节的区块;一个真正的内核分配器需要同时处理小与大的内存分配需求。
3.10 练习
- 解析 RISC-V 的设备树,以找出这台电脑的物理内存容量。
- 编写一个用户程序,通过调用
sbrk(1)来使地址空间增加一个字节。运行该程序,并考察调用sbrk之前和之后该程序的页表。内核实际上分配了多少空间?新分配的内存对应的 PTE 中包含什么内容? - 修改 xv6,使内核可以使用超级页。
- 修改 xv6,使得用户程序解引用空指针时会收到异常。也就是说,修改 xv6,使得用户程序的虚拟地址 0 不被映射。
- Unix 系统对
exec的实现传统上会对 shell 脚本做特殊处理。如果要执行的文件以文本#!开头,那么首行会被视为用来解释该文件的程序。例如,若调用exec运行myprog arg1,而myprog的第一行是#!/interp,那么exec实际上会以/interp myprog arg1作为命令行来运行/interp。在 xv6 中实现对这一惯例的支持。 - 为内核实现地址空间随机化。
第 4 章 陷入与系统调用
有三种类型的事件会使 CPU 暂停正常的指令执行流程,并强制把控制权转移给处理该事件的专门代码。第一种情况是系统调用:用户程序执行 ecall 指令,请求内核为它做某件事。第二种情况是异常(exception):某条指令(无论来自用户还是内核)做了非法操作,例如除以零或使用无效的虚拟地址。第三种情况是设备中断(interrupt):某个设备发出信号表示它需要被处理,例如磁盘硬件完成了一次读写请求。
本书用「陷入」(trap)一词作为这些情况的统称。通常,陷入发生时正在执行的代码之后需要能够恢复运行,并且不必察觉到任何特殊的事情发生了。也就是说,我们通常希望陷入是透明的;这一点在设备中断时尤其重要,因为被中断的代码通常不会预期到被打断。一般的流程是:陷入发生后控制权转移到内核;内核保存寄存器与其他状态,以便之后能够恢复执行;内核运行相应的处理程序(例如系统调用的实现或设备驱动程序);内核还原先前保存的状态并从陷入返回;原本的代码从中断处继续运行。
xv6 在内核中处理所有陷入,陷入不会交由用户代码处理。对系统调用来说,在内核中处理陷入是理所当然的。对中断来说也是合理的:隔离的要求决定了只有内核能够操作设备,而且内核本身就是让多个进程共享设备的一个便利机制。对异常来说同样合理,因为 xv6 对来自用户空间的所有异常都以终止出错的程序作为回应。
xv6 的陷入处理分为四个阶段:第一阶段是 RISC-V CPU 执行的硬件动作;第二阶段是一小段汇编指令,为内核的 C 代码做准备;第三阶段是一个 C 函数,它决定该如何处理这个陷入;第四阶段则是系统调用或设备驱动服务例程。
尽管这三种陷入有不少共通性,理论上内核可以用一条通用的代码路径处理所有陷入,但实际更方便的做法是为三种不同情况编写各自的代码:来自用户空间的陷入、来自内核空间的陷入,以及时钟中断。处理陷入的内核代码(无论是汇编还是 C)通常被称为处理程序(handler);最先运行的那几条处理程序指令通常以汇编语言而非 C 编写,有时也被称为「vector」。
4.1 RISC-V 的陷入机制
每个 RISC-V CPU 都有一组控制寄存器:内核写入这些寄存器以告诉 CPU 该如何处理陷入,也可以读取这些寄存器来得知已经发生的陷入的相关信息。RISC-V 的官方文档中有完整的说明[1]。riscv.h(kernel/riscv.h:1)中包含了 xv6 使用的相关定义。以下是几个最重要的寄存器简介:
stvec:内核把它的陷入处理程序地址写入这里;发生陷入时,RISC-V 跳到stvec所指定的地址运行处理该陷入的处理程序。sepc:发生陷入时,RISC-V 把当下的程序计数器保存在此处(因为pc随即会被stvec的值覆盖)。sret(从陷入返回的指令)把sepc的内容拷贝回pc。内核也可以通过写入sepc来控制sret返回的位置。scause:RISC-V 在此处写入一个数值,描述这次陷入的原因。sscratch:内核在这里放置一个值,这个值在陷入处理程序的最开始会派上用场。sstatus:此寄存器中的 SIE 位控制设备中断是否开启。如果内核清除此位,RISC-V 会延后处理设备中断,直到内核再次设置它。SPP 位表示这次陷入是从用户模式还是特权模式进入的,并决定sret返回到哪一级模式。
上述这些寄存器都与在特权模式下处理的陷入有关,在用户模式中无法读写它们。针对在机器模式下处理的陷入,还有一组相似的控制寄存器;xv6 只在时钟中断这一特殊情况下使用它们。
多核芯片上的每个 CPU 都各有一组这些寄存器,并且任一时刻都可能有多个 CPU 同时在处理陷入。
当需要强制进入陷入时,RISC-V 硬件会对所有类型的陷入(时钟中断除外)执行以下动作:
- 如果这次陷入是设备中断,且
sstatus的 SIE 位为清除状态,则不执行后面的任何步骤。 - 清除
sstatus中的 SIE 位以关闭中断。 - 把
pc的值拷贝到sepc。 - 把当前模式(用户或特权)保存在
sstatus的 SPP 位中。 - 把
scause设置为反映此次陷入的原因。 - 把运行模式设为特权模式。
- 把
stvec的值拷贝到pc。 - 从新的
pc开始执行。
请注意,CPU 在陷入发生时不会自动切换到内核页表,不会切换到内核栈,除了 pc 之外也不会保存任何其他寄存器。这些任务必须由内核软件来完成。CPU 在处理陷入时只做最少的工作,原因之一是要给软件更多灵活性;例如,有些操作系统会在特定情况下省去页表切换,以提升陷入的性能。
值得思考的是我们能否省略上述步骤中的某些部分,以更快速地处理陷入。虽然在某些情况下更简化的流程是可行的,但总体上省略上面大多数步骤都会造成危险。例如,假设 CPU 不切换程序计数器,那么来自用户空间的陷入就可能在仍在执行用户指令的情况下进入特权模式。这些用户指令可能会破坏用户与内核之间的隔离,例如修改 satp 寄存器,使其指向一张允许访问整个物理内存的页表。因此,CPU 切换到由内核指定的指令地址(即 stvec)是非常重要的。
4.2 来自用户空间的陷入
xv6 会根据陷入发生时是在内核中还是在用户代码中执行而采取不同的处理方式。本节讲述来自用户代码的陷入的流程;来自内核代码的陷入将在第 4.5 节说明。
在用户空间中执行时,如果用户程序发起系统调用(ecall 指令)、做了不合法的操作,或者有设备中断发生,都可能产生陷入。来自用户空间的陷入,其高层路径为:先进入 uservec(kernel/trampoline.S:16),接着进入 usertrap(kernel/trap.c:37);返回用户空间时会先经过 usertrapret(kernel/trap.c:90),最后再通过 userret(kernel/trampoline.S:88)回到用户程序。
xv6 陷入处理机制的设计有一个主要约束:RISC-V 硬件在触发陷入时并不会自动切换页表。这意味着 stvec 中指向的陷入处理程序地址必须在用户页表中有一个有效的映射,因为陷入处理代码开始执行时使用的仍是用户页表。此外,xv6 的陷入处理代码还需要切换到内核页表;为了让处理程序在切换后能够继续执行,内核页表也必须对 stvec 所指向的处理程序有一份映射。
xv6 用 trampoline 页来满足这些需求。trampoline 页包含着 uservec,也就是 stvec 所指向的陷入处理代码。xv6 在每个进程的页表中把 trampoline 页映射到 TRAMPOLINE 这个地址;该地址位于虚拟地址空间的最顶端,因此会高于程序自己使用的内存。trampoline 页在内核页表中也被映射到 TRAMPOLINE 这个地址,参见图 2.3 和图 3.3。因为 trampoline 页带着 PTE_U 标志映射在用户页表中,陷入发生后可以以特权模式从那里开始执行;又因为 trampoline 页在内核地址空间中被映射到同一个地址,陷入处理程序切换到内核页表之后仍能继续执行。
uservec 这段陷入处理程序的代码写在 trampoline.S 中(kernel/trampoline.S:16)。当 uservec 开始执行时,32 个寄存器里都还是被打断的用户代码的值。这 32 个值需要被保存到内存中的某处,以便陷入返回用户空间时能够还原它们。但向内存写入必须有一个寄存器来存放地址,而此时没有任何通用寄存器可用!所幸 RISC-V 提供了帮助:sscratch 寄存器。uservec 开头的 csrrw 指令会交换 a0 与 sscratch 的内容:用户代码的 a0 由此被保存到 sscratch 中;uservec 得到了一个可以自由使用的寄存器(a0),而 a0 里装的是内核先前放入 sscratch 的值。
uservec 接下来的任务是把 32 个用户寄存器全部保存起来。进入用户空间之前,内核已经把 sscratch 设置为指向一个每进程私有的 trapframe 结构,它(除了别的内容之外)有用来保存这 32 个用户寄存器的空间(kernel/proc.h:44)。由于此时 satp 仍指向用户页表,uservec 访问内存时,trapframe 必须在用户地址空间中有映射。创建每个进程时,xv6 会为它的 trapframe 分配一页,并让这一页始终映射在用户虚拟地址 TRAPFRAME 上,该地址就在 TRAMPOLINE 的正下方。进程的 p->trapframe 指针也指向这个 trapframe,不过指向的是它的物理地址,这样内核就能通过内核页表访问它。
因此,在交换 a0 和 sscratch 之后,a0 中就是当前进程 trapframe 的指针。uservec 现在把所有用户寄存器值都存到那里,其中包括刚从 sscratch 读出的用户的 a0。trapframe 中包含当前进程的内核栈地址、当前 CPU 的 hartid、usertrap 函数的地址,以及内核页表的地址。uservec 取出这些值,把 satp 切换为内核页表,然后调用 usertrap。
usertrap 的工作是判断陷入的原因、处理它,然后返回(kernel/trap.c:37)。它一开始会修改 stvec,这样之后内核里如果再次发生陷入,就会交给 kernelvec 而不是 uservec 处理。接着它会保存 sepc 寄存器(即保存下来的用户程序计数器),因为 usertrap 可能调用 yield 切换到其他进程的内核线程,而那个进程在返回用户空间的过程中会改写 sepc。如果该陷入是系统调用,usertrap 会调用 syscall 处理它;如果是设备中断,就调用 devintr;否则就是异常,内核会把出错的进程杀掉。系统调用这条路径会把保存的用户程序计数器加上 4,因为对系统调用而言,RISC-V 让程序计数器仍指向 ecall 那条指令,而用户代码需要从下一条指令继续执行。在离开之前,usertrap 还会检查这个进程是否已经被杀死,或者(如果这次陷入是时钟中断)是否应该让出 CPU。
返回用户空间的第一步是调用 usertrapret(kernel/trap.c:90)。这个函数设置 RISC-V 的控制寄存器,为将来从用户空间发生的陷入做准备:这包括把 stvec 改回指向 uservec、准备好 uservec 所依赖的 trapframe 字段,并把 sepc 设置为先前保存的用户程序计数器。最后,usertrapret 在 trampoline 页上调用 userret;这一页同时映射在用户页表和内核页表中,原因是 userret 中的汇编代码会切换页表。
usertrapret 调用 userret 时,在 a0 中传入 TRAPFRAME,在 a1 中传入进程用户页表的指针(kernel/trampoline.S:88)。userret 把 satp 切换为该进程的用户页表。回想一下,用户页表映射了 trampoline 页和 TRAPFRAME,但内核的其他部分都不映射。trampoline 页在用户页表和内核页表中被映射到相同的虚拟地址,正是这一点让 uservec 能在改变 satp 之后继续执行。userret 把 trapframe 中保存的用户 a0 拷贝到 sscratch,为稍后与 TRAPFRAME 的交换做好准备。从这一刻起,userret 能使用的数据只有寄存器内容和 trapframe 的内容。接下来 userret 从 trapframe 恢复保存的用户寄存器,最后再交换一次 a0 与 sscratch,以还原用户的 a0 并把 TRAPFRAME 留给下一次陷入,然后执行 sret 指令返回用户空间。
4.3 代码:发起系统调用
第 2 章结尾提到了 initcode.S 会调用 exec 这个系统调用(user/initcode.S:11)。现在我们来看看,这个来自用户空间的调用是怎么一路传递到内核中对应的 exec 实现的。
initcode.S 会把传给 exec 的参数放进 a0 和 a1 寄存器中,并将系统调用的编号放进 a7。系统调用编号对应到 syscalls 数组中的条目,这个数组是一张函数指针表(kernel/syscall.c:108)。接着 ecall 指令触发陷入进入内核,如前所述,这会依次执行 uservec、usertrap 与 syscall。
syscall(kernel/syscall.c:133)从 trapframe 中保存的 a7 读出系统调用编号,并用它去查找 syscalls 数组。第一次的系统调用中,a7 里是 SYS_exec(kernel/syscall.h:8),因此会调用到对应的实现函数 sys_exec。
当 sys_exec 执行完毕并返回时,syscall 会把它的返回值写进 p->trapframe->a0。这样做的原因是,RISC-V 的 C 调用惯例把返回值放在 a0 中,因此这样可以让原本用户空间中的 exec() 调用收到正确的返回值。惯例上,系统调用出错时返回负数,成功时返回 0 或正数。若系统调用编号不合法,syscall 会打印错误消息并返回 -1。
4.4 代码:系统调用参数
内核中的系统调用实现需要取得用户代码传入的参数。由于用户代码调用的是系统调用包装函数,这些参数起初位于 RISC-V 的 C 调用惯例所规定的位置:寄存器中。内核的陷入处理流程会把用户寄存器的内容保存到当前进程的 trapframe 中,内核代码之后可以从那里找到它们。内核提供了 argint、argaddr 和 argfd 等函数,分别用来把第 n 个系统调用参数从 trapframe 中取出来,作为整数、指针或文件描述符使用。这些函数内部都会调用 argraw,以取得对应的用户寄存器(kernel/syscall.c:35)。
有些系统调用会把指针作为参数传入,而内核必须使用这些指针去读写用户内存。例如,exec 系统调用会传给内核一个数组,其中是指向用户空间中字符串参数的指针。这些指针带来两个挑战:第一,用户程序中可能有 bug 或是恶意代码,可能会传入一个无效的指针,甚至试图诱骗内核访问内核内存而不是用户内存;第二,xv6 的内核页表映射与用户页表映射不同,因此内核不能直接用普通指令从用户提供的地址读写数据。
内核实现了一些函数,以安全地在用户提供的地址与内核之间传送数据。fetchstr 就是一例(kernel/syscall.c:25),像 exec 这样的文件系统调用会用 fetchstr 从用户空间读取字符串形式的文件名参数。fetchstr 本身调用 copyinstr 来完成底层的拷贝工作。
copyinstr(kernel/vm.c:398)从用户页表 pagetable 中的虚拟地址 srcva 拷贝最多 max 个字节的数据到 dst。由于 pagetable 并不是当前使用的页表,copyinstr 会使用 walkaddr(它会调用 walk)在 pagetable 中查找 srcva 对应的物理地址 pa0。内核把每个物理 RAM 地址都映射到对应的内核虚拟地址,所以 copyinstr 可以直接把字符串字节从 pa0 拷贝到 dst。walkaddr(kernel/vm.c:104)还会检查用户提供的虚拟地址是否确实属于该进程的用户地址空间,这样程序就无法诱骗内核去读取其他内存。另一个类似的函数是 copyout,它把数据从内核拷贝到用户提供的地址。
4.5 来自内核空间的陷入
根据正在执行的是用户代码还是内核代码,xv6 对 CPU 陷入寄存器的配置有所不同。当内核在某个 CPU 上执行时,内核让 stvec 指向 kernelvec 处的汇编代码(kernel/kernelvec.S:10)。由于 kernelvec 只有在 xv6 已处于内核中时才会运行,kernelvec 可以假定 satp 已经指向内核页表,且栈指针已经指向一个合法的内核栈。kernelvec 会把 32 个寄存器的值全部压入栈中,之后再从中还原,让被打断的内核代码能够不受干扰地继续执行。
kernelvec 把寄存器内容保存在被打断的内核线程的栈上,因为这些寄存器的值本来就属于该线程。当陷入导致切换到另一个线程时,这一点特别重要:那种情况下陷入实际上会从新线程的栈返回,而原本被打断的线程保存的寄存器内容则安全地留在它自己的栈上。
在把寄存器压入栈之后,kernelvec 跳转到 kerneltrap(kernel/trap.c:134)。kerneltrap 要处理两种陷入:设备中断与异常。它会调用 devintr(kernel/trap.c:177)来检测并处理设备中断。如果这个陷入不是设备中断,那就一定是异常,而在 xv6 的内核中异常一律是致命错误;此时内核调用 panic 并停止执行。
如果这次 kerneltrap 是由时钟中断触发的,而且当前运行的是某个进程的内核线程(而不是调度器线程),kerneltrap 就会调用 yield,让其他线程有机会运行。之后某个线程会再次调用 yield,使我们原本的线程与它的 kerneltrap 恢复运行。第 7 章会解释 yield 中具体发生了什么。
当 kerneltrap 处理完毕后,它需要返回到被这次陷入打断的那段代码。由于 yield 可能已经改动了 sepc 和 sstatus 中的前一级模式,kerneltrap 在开始时就先把它们保存下来;现在它还原这些控制寄存器,并返回到 kernelvec(kernel/kernelvec.S:48)。kernelvec 从栈中弹出先前保存的寄存器,然后执行 sret 指令,这会把 sepc 的值写回 pc,从而恢复被打断的内核代码。
值得仔细想一想:如果 kerneltrap 是因为时钟中断而调用了 yield,这个陷入的返回是怎么完成的。
当某个 CPU 从用户空间进入内核时,xv6 会把该 CPU 的 stvec 设置为 kernelvec;你可以在 usertrap 中看到这段代码(kernel/trap.c:29)。但在内核已经开始执行、而 stvec 仍指向 uservec 的这个时间窗口内,绝对不能发生设备中断。所幸 RISC-V 在开始进入陷入时总会关闭中断,而 xv6 在设置好 stvec 之前不会重新打开中断。
4.6 缺页异常
xv6 对异常的反应相当无聊:如果异常发生在用户空间,内核就把出错的进程杀掉;如果异常发生在内核,内核就直接 panic。真正的操作系统通常会用更有趣的方式回应这些情况。
举个例子,许多内核利用缺页来实现写时复制(copy-on-write,COW)型的 fork。为了解释写时复制 fork,让我们回到第 3 章提到的 xv6 的 fork。fork 使子进程初始的内存内容与父进程在 fork 时刻的内存内容相同。xv6 用 uvmcopy(kernel/vm.c:301)实现这一点,它为子进程分配物理内存,并把父进程的内存内容拷贝进去。如果父进程和子进程能共享父进程的物理内存,效率会更高。不过直接这样做行不通,因为它们会向共享的栈和堆写入,互相干扰对方的执行。
只要恰当地使用页表权限与缺页机制,父进程和子进程是可以安全地共享物理内存的。当某个虚拟地址在页表中没有映射,或其映射的 PTE_V 标志被清零,或其权限位(PTE_R、PTE_W、PTE_X、PTE_U)不允许所尝试的操作时,CPU 就会产生缺页异常。RISC-V 区分三种缺页:载入缺页(load page fault,load 指令无法转换其虚拟地址时)、存储缺页(store page fault,store 指令无法转换其虚拟地址时)和取指缺页(instruction page fault,程序计数器中的地址无法转换时)。scause 寄存器会指出是哪种缺页,而 stval 寄存器中放着无法被转换的地址。
COW fork 的基本方案是:父进程和子进程一开始共享所有的物理页,但各自把这些页映射为只读(PTE_W 标志清零)。父进程和子进程都可以读取这段共享内存;但任何一方写入某个页时,RISC-V CPU 就会产生一个缺页异常。内核的陷入处理程序对此的回应是:分配一页新的物理内存,把出错地址所映射到的那个物理页的内容拷贝进去。然后内核把出错进程页表中相应的页表项改为指向这份拷贝,并允许读和写,再让出错的进程从造成这次缺页的指令重新执行。由于该页表项已允许写入,重新执行的这条指令就不会再触发缺页。写时复制需要额外的簿记来帮助判断物理页何时可以被释放,因为每个页可能被数量不等的页表引用,具体数目取决于 fork、缺页、exec 和 exit 的历史。这套簿记还带来一个重要优化:如果某个进程发生存储缺页,而该物理页只被它自己的页表引用,那就不需要拷贝。
写时复制让 fork 更快,因为 fork 时不需要拷贝内存。有些内存要到后来被写入时才需要拷贝,但实际上大多数内存往往永远不必被拷贝。一个常见的例子是先 fork 紧接着 exec:fork 之后可能只有少数几个页被写入,而子进程的 exec 又会释放从父进程继承来的大部分内存。写时复制 fork 让这部分内存自始至终不必被拷贝。此外,COW fork 是透明的:应用程序无需做任何修改就能自动受益。
页表与缺页的组合,除了 COW fork 之外还开启了大量有趣的可能。另一个被广泛使用的机制是惰性分配(lazy allocation),它包含两步。第一步,当应用程序调用 sbrk 请求更多内存时,内核记下要增加的大小,但不分配物理内存,也不为这段新的虚拟地址区间创建页表项。第二步,当这些新地址中的某一个发生缺页时,内核才真正分配一页物理内存并把它映射进页表。和 COW fork 一样,惰性分配也可以由内核对应用程序透明地实现。
由于应用程序常常请求比实际需要更多的内存,惰性分配在这种情况下非常划算:对于应用程序从未实际使用的页,内核根本不需要做任何工作。此外,如果应用程序要一次增长大量地址空间,没有惰性分配的 sbrk 成本会非常高:应用程序请求 1GB 内存时,内核必须分配并清零 262,144 个 4096 字节的页。惰性分配能让这笔成本随时间摊平。但另一方面,惰性分配会带来额外的缺页开销,因为每次缺页都涉及一次内核/用户模式的切换。操作系统可以通过两种方式降低成本:每次缺页时批量分配多个连续的页而不是只分配一个页,以及针对这类缺页特化内核的进出路径。
另一个被广泛使用、依赖缺页的功能是按需调页(demand paging)。在 xv6 的 exec 中,应用程序的所有 text 和 data 会在启动前就被急切地全部加载进内存。由于应用程序可能很大,而从磁盘读数据又很耗时,这笔启动成本对用户来说可能会很明显:用户从 shell 启动一个大型应用程序时,可能要过很久才能看到响应。为了改善响应时间,现代内核一开始并不把可执行文件加载进内存,而是先创建用户地址空间的页表,并把其中所有页表项标为无效。每当程序第一次使用某个页,就会发生缺页,内核随即从磁盘读入该页的内容并映射进用户地址空间。和 COW fork 与惰性分配一样,这个机制也可以对应用程序透明地实现。
电脑上运行的程序可能需要超过机器 RAM 容量的内存。为了从容应对这种情况,操作系统可能会实现换页到磁盘(paging to disk):只在 RAM 中保留一部分用户的页,其余的保存在磁盘上的换页区(paging area)中。内核把对应于换页区中数据(即不在 RAM 中)的页表项标为无效。如果应用程序试图使用某个已被换出到磁盘的页,就会发生缺页,而该页必须被换入:内核的陷入处理程序会分配一页物理 RAM,把该页从磁盘读入 RAM,并修改相应的页表项使其指向这块 RAM。
如果需要换入一个页,但当下没有任何空闲的物理 RAM 怎么办?这种情况下,内核必须先释放出一个物理页:把某个页换出(逐出)到磁盘上的换页区,并把引用该物理页的页表项全部标为无效。逐出的成本很高,所以换页在很少发生时表现最好:应用程序只使用其内存页的一个子集,而这些子集的并集能装进 RAM。这种特性通常被称为具有良好的引用局部性(locality of reference)。和许多其他虚拟内存技术一样,内核通常会让换页到磁盘对应用程序保持透明。
即使硬件提供了大量 RAM,电脑在实际运作时仍经常处于几乎没有空闲物理内存的状态。例如,云服务提供者为了经济地利用硬件,通常会在单一机器上多路复用许多客户的应用程序;又如,用户会在只有少量物理内存的智能手机上同时运行许多应用程序。在这样的场景中,每次分配一个新页之前都可能必须先逐出一个现有的页。因此,当物理内存资源紧张时,分配内存的成本更高。
在可用内存紧张、而程序实际上只使用其分配内存的一部分时,惰性分配和按需调页特别有优势。在 sbrk 或 exec 中急切地分配内存,会额外付出为腾出内存而逐出页面的成本。而且这些急切的工作还有被浪费的风险:因为操作系统可能在应用程序用到某个页之前就已经把它逐出了。
其他结合了分页与缺页异常的功能还包括自动扩展的栈以及内存映射文件。
4.7 现实世界
trampoline 与 trapframe 的设计看起来可能过于复杂。背后的一个推动力是:RISC-V 在触发陷入时刻意尽量少做事,以便有可能做出非常快的陷入处理,而这在实现上非常重要。结果就是内核陷入处理程序的前几条指令实际上必须在用户环境下执行:使用用户页表,寄存器里还是用户的内容。而且陷入处理程序起初并不知道一些有用的信息,比如「当前运行的进程是谁」或「内核页表的地址」。这些问题之所以有解,是因为 RISC-V 提供一些受保护的地方,让内核可以在进入用户空间之前存放信息:sscratch 寄存器,以及指向内核内存、靠不设 PTE_U 标志来保护的用户页表项。xv6 的 trampoline 与 trapframe 正是善用了这些 RISC-V 特性。
如果内核内存也被映射进每个进程的用户页表(并带上有针对性的 PTE 权限标志),那就不需要专门的 trampoline 页了。这样一来,从用户空间陷入内核时也就不需要切换页表;这又让内核中的系统调用实现可以利用当前进程的用户内存已被映射这一点,直接解引用用户指针。许多操作系统都用这类设计来提升效率。xv6 避免这种设计,是为了减少内核因不小心使用用户指针而产生安全漏洞的机会,也简化了确保用户与内核虚拟地址不重叠所需的处理。
生产级操作系统会实现写时复制 fork、惰性分配、按需调页、换页到磁盘、内存映射文件等机制。此外,生产级操作系统会设法让所有物理内存都派上用场,要么给应用程序,要么给缓存(例如第 8.2 节要讲的文件系统缓冲区缓存)。在这方面 xv6 很幼稚:你当然希望操作系统用上你花钱买的物理内存,但 xv6 不会。而且,如果 xv6 用完了内存,它会把错误返回给正在运行的应用程序,或者直接把它杀掉,而不会去逐出另一个应用程序的某个页。
4.8 练习
copyin和copyinstr通过软件方式走访用户页表。请设置内核页表,使内核直接映射用户程序,让copyin和copyinstr可以用memcpy把系统调用参数拷贝进内核空间,依靠硬件来完成页表走访。- 实现惰性内存分配。
- 实现 COW
fork。 - 有没有办法去掉每个用户地址空间中特殊的
TRAPFRAME页映射?例如,能否修改uservec,让它直接把 32 个用户寄存器压入内核栈,或者存放到proc结构中? - 能否修改 xv6,去掉对
TRAMPOLINE页的映射?
第 5 章 中断与设备驱动
驱动(driver)是操作系统中负责管理某种特定设备的代码:它会配置设备的硬件、命令设备执行操作、处理由此产生的中断,并与那些可能正在等待该设备 I/O 的进程交互。驱动的代码常常很棘手,因为它与它所管理的设备是并发运行的。此外,驱动还必须理解设备的硬件接口,而这些接口可能很复杂,也可能缺乏良好的文档说明。
需要操作系统处理的设备通常可以被配置成会产生中断,中断是陷入(trap)的一种类型。内核的陷入处理代码会识别出设备已经发出了中断,并调用对应驱动的中断处理程序;在 xv6 中,这个分发过程发生在 devintr(kernel/trap.c:177)里。
许多设备驱动的代码会在两种上下文下运行:一种是称为上半部(top half)的部分,它在进程的内核线程里运行;另一种是称为下半部(bottom half)的部分,它在中断到来时运行。上半部由 read、write 之类要求设备执行 I/O 的系统调用调用。这部分代码可能会请求硬件开始某个操作(例如请磁盘读取一个块),然后等待操作完成。最终设备完成该操作并触发一次中断。驱动的中断处理程序作为下半部,会判断是哪个操作完成了,在必要时唤醒等待的进程,并通知硬件开始处理下一个等待中的操作。
5.1 代码:控制台输入
控制台驱动(kernel/console.c)是对驱动结构的一个简明示例。控制台驱动通过接在 RISC-V 上的 UART 串口硬件接收人类键入的字符,它会一次累积一整行输入,并处理像退格键和 control-u 这样的特殊输入字符。像 shell 这样的用户进程使用 read 系统调用从控制台读取整行输入。当你在 QEMU 中向 xv6 输入时,你的按键会经由 QEMU 仿真的 UART 硬件传递给 xv6。
驱动所操作的 UART 硬件是由 QEMU 仿真的 16550 芯片[12]。在真实的电脑上,16550 芯片通常用来管理一条 RS232 串行连接,连到终端机或另一台电脑。而运行 QEMU 时,它连接的是你的键盘和显示器。
从软件的角度看,UART 硬件就是一组内存映射(memory-mapped)的控制寄存器。也就是说,RISC-V 硬件把某些物理地址连接到 UART 设备,使得对这些地址的 load 与 store 操作实际上是与设备硬件交互,而不会访问 RAM。UART 的内存映射地址从 0x10000000 开始,也就是 UART0(kernel/memlayout.h:21)。UART 有若干控制寄存器,每个寄存器的宽度都是一个字节,它们相对于 UART0 的偏移量定义在(kernel/uart.c:22)里。例如,LSR 寄存器中的某些位表示是否有输入字符正等待软件读取,这些字符(如果有的话)可以从 RHR 寄存器读出。每读取一个,UART 硬件就会把它从内部等待字符的 FIFO 中删除,并在 FIFO 清空时一并清除 LSR 中的 “ready” 位。UART 的发送硬件与接收硬件基本上是相互独立的;如果软件向 THR 写入一个字节,UART 就会发送该字节。
xv6 的 main 会调用 consoleinit(kernel/console.c:182)来初始化 UART 硬件。这段代码会配置 UART,使它在每接收一个输入字节时产生接收中断,在每发送完一个输出字节时产生发送完成中断(kernel/uart.c:53)。
xv6 的 shell 通过一个由 init.c 打开的文件描述符(user/init.c:19)从控制台读取数据。对 read 系统调用的调用会一路穿过内核,最终到达 consoleread(kernel/console.c:80)。consoleread 会等待输入通过中断抵达并暂存在 cons.buf 中,然后把输入拷贝到用户空间,并在整行输入到达后返回给用户进程。如果用户还没有输入完整的一行,任何调用 read 的进程都会停在 sleep 调用(kernel/console.c:96)中(第 7 章会详细说明 sleep 的运作)。
当用户键入一个字符时,UART 硬件会请求 RISC-V 产生一次中断,这会激活 xv6 的陷入处理程序。陷入处理程序接着调用 devintr(kernel/trap.c:177),它会查看 RISC-V 的 scause 寄存器,以判断该中断来自外部设备。然后它会向一个名为 PLIC 的硬件单元查询是哪个设备产生了中断(kernel/trap.c:186)。如果是 UART,devintr 会调用 uartintr。
uartintr(kernel/uart.c:180)会从 UART 硬件中读取所有等待处理的输入字符,并把这些字符交给 consoleintr(kernel/console.c:136);它本身不等待更多输入,因为将来有新输入时会再次触发新的中断。consoleintr 的任务是把输入字符累积到 cons.buf 中,直到一整行到达为止。consoleintr 会对退格键和其他几个特殊字符做特别处理。当换行符到达时,consoleintr 会唤醒正在等待的 consoleread(如果有的话)。
一旦被唤醒,consoleread 就会看到 cons.buf 中已有完整的一行,把它拷贝到用户空间,然后(经由系统调用机制)返回用户空间。
5.2 代码:控制台输出
对已连接到控制台的某个文件描述符所做的 write 系统调用,最终会到达 uartputc(kernel/uart.c:87)。设备驱动维护了一个输出缓冲区(uart_tx_buf),使得执行写入的进程不必等待 UART 发送完毕;uartputc 会把每个字符追加到缓冲区,调用 uartstart 启动设备发送(如果尚未开始),然后直接返回。uartputc 唯一会等待的情况,就是缓冲区已经满了。
每当 UART 发送完一个字节,它就会生成一次中断。uartintr 会调用 uartstart,该函数检查设备是否真的完成了发送,然后把缓冲区中的下一个输出字符交给设备发送。因此,如果某个进程一次向控制台写入多个字节,通常第一个字节是由 uartputc 调用 uartstart 发送出去的,而其余暂存在缓冲区里的字节,则会在每次发送完成中断到来时由 uartintr 调用 uartstart 陆续发送出去。
一个值得注意的普遍模式,是通过缓冲区和中断把设备活动与进程活动解耦。控制台驱动即使在没有进程等待读取时也能处理输入;随后的 read 调用就能读到这些输入。同样地,进程发送输出时也不必等待设备。这种解耦能让进程与设备 I/O 并发执行,从而提升性能;当设备很慢(像 UART)或者需要立即响应(像回显键入的字符)时,这一点尤其重要。这种理念有时被称为 I/O 并发(I/O concurrency)。
5.3 驱动中的并发
你可能已经注意到 consoleread 和 consoleintr 中有对 acquire 的调用。这些调用会获取一把锁,保护控制台驱动的数据结构不被并发访问。这里存在三种并发危险:其一,两个位于不同 CPU 上的进程可能同时调用 consoleread;其二,当某个 CPU 已经在 consoleread 内部执行时,硬件可能请求它交付一次控制台(实际上是 UART)中断;其三,当某个 CPU 正在执行 consoleread 时,硬件可能在另一个 CPU 上交付一次控制台中断。这些危险可能导致竞态条件或死锁。第 6 章会探讨这些问题以及锁如何解决它们。
在驱动中,并发需要小心的另一个方面是:某个进程可能正在等待某个设备的输入,但用来通知输入到达的中断,可能在另一个进程(或根本没有进程)运行时到达。因此,中断处理程序不允许去考虑它所打断的进程或代码。例如,中断处理程序不能安全地用当前进程的页表去调用 copyout。中断处理程序通常只做相对较少的工作(例如只把输入数据拷贝到一个缓冲区),然后唤醒上半部代码来完成其余工作。
5.4 时钟中断
xv6 使用时钟中断(timer interrupt)来维护它的时钟,并使其能够在计算密集型的多个进程之间切换;usertrap 和 kerneltrap 中的 yield 调用促成了这种切换。时钟中断来自接在每个 RISC-V CPU 上的时钟硬件。xv6 会对这块时钟硬件编程,让它周期性地对每个 CPU 产生中断。
RISC-V 要求时钟中断必须在机器模式下被处理,而不是在特权模式下。RISC-V 的机器模式在不启用分页的情况下运行,并且有一套独立的控制寄存器,所以在机器模式里运行普通的 xv6 内核代码并不现实。因此,xv6 把时钟中断的处理与上文所述的陷入机制完全分开。
在 main 之前、于 start.c 中在机器模式下执行的代码会设置好以接收时钟中断(kernel/start.c:62)。这项工作的一部分是对 CLINT 硬件(核心本地中断器,core-local interruptor)编程,让它在一定的延迟之后产生一次中断。另一部分是设置一块暂存区,类似于 trapframe,用来帮助时钟中断处理程序保存寄存器以及 CLINT 寄存器的地址。最后,start 会把 mtvec 设置为 timervec 并启用时钟中断。
时钟中断可以在用户代码或内核代码执行的任何时刻发生;内核没有办法在关键操作期间禁用时钟中断。因此,时钟中断处理程序必须以一种保证不会扰动被打断的内核代码的方式来完成它的工作。基本策略是:处理程序请求 RISC-V 产生一次“软件中断”,然后立即返回。RISC-V 会用普通的陷入机制把软件中断交付给内核,并允许内核禁用它们。处理由时钟中断所引发的软件中断的代码可以在 devintr(kernel/trap.c:204)中看到。
机器模式下的时钟中断处理程序是 timervec(kernel/kernelvec.S:93)。它把几个寄存器保存到 start 准备好的暂存区,告诉 CLINT 何时产生下一次时钟中断,请求 RISC-V 产生一次软件中断,恢复寄存器,然后返回。时钟中断处理程序里没有 C 代码。
5.5 现实世界
xv6 在内核态执行时以及执行用户程序时,都允许设备中断和时钟中断。时钟中断会强制从时钟中断处理程序发起一次线程切换(一次 yield 调用),即使在内核态执行时也是如此。当内核线程有时会花费大量时间计算而不返回用户空间时,能够在内核线程之间公平地按时间片分配 CPU 是很有用的。然而,内核代码必须意识到它可能会(因时钟中断而)被挂起、随后又在另一个 CPU 上恢复运行,这种需求是 xv6 中一些复杂性的来源(见 6.6 节)。如果设备中断和时钟中断只在执行用户代码时发生,内核本可以做得更简单些。
要完整地支持一台典型电脑上的所有设备是一件非常繁琐的工作,因为设备种类繁多,每种设备又有很多功能,而且设备与驱动之间的通信协议可能很复杂、缺乏良好的文档说明。在许多操作系统中,驱动所占的代码量往往超过了核心内核本身。
UART 驱动通过读取 UART 控制寄存器、每次取回一个字节的方式来获取数据;因为是软件在驱动数据的搬移,这种模式被称为程序控制 I/O(programmed I/O)。程序控制 I/O 实现简单,但速度太慢,无法用于高数据速率的场合。需要高速搬移大量数据的设备通常使用直接内存访问(DMA)。DMA 设备硬件会把传入的数据直接写入 RAM,也从 RAM 中读取要发送的数据。现代的磁盘和网络设备都使用 DMA。DMA 设备的驱动会先在 RAM 中准备好数据,然后用一次对控制寄存器的写入来通知设备处理这些数据。
当设备需要在不可预测的时刻获得关注、而且这种关注不太频繁时,使用中断是合理的。但中断的 CPU 开销很高,因此像网络或磁盘控制器这样的高速设备会使用一些技巧来减少对中断的需求。一种技巧是对一整批传入或传出的请求只产生一次中断。另一种技巧是驱动完全禁用中断,转而周期性地检查设备是否需要处理,这种技术称为轮询(polling)。如果设备操作进行得很快,轮询是合适的;但如果设备大多时间处于空闲,轮询就会浪费 CPU 时间。有些驱动会根据当前的设备负载,在轮询和中断两种模式之间动态切换。
UART 驱动会把传入的数据先拷贝到内核中的一个缓冲区,再拷贝到用户空间。在低数据速率下这样做是合理的,但对于产生或消耗数据很快的设备,这样的两次拷贝会显著降低性能。有些操作系统能够直接在用户空间缓冲区和设备硬件之间搬移数据,这通常需要通过 DMA 来完成。
如第 1 章所述,控制台在应用程序看来就像是一个普通的文件,应用程序使用 read 和 write 系统调用来读取输入、写出输出。应用程序可能想控制设备的某些无法用标准文件系统调用表达的方面(例如启用/禁用控制台驱动的行缓冲)。Unix 操作系统为这类情况提供了 ioctl 系统调用。
电脑的某些用途要求系统必须在有限的时间内做出响应。例如在安全攸关的系统中,错过截止时间可能会导致灾难。xv6 不适合硬实时(hard real-time)场合。面向硬实时的操作系统往往是与应用程序链接的库,从而能够进行最坏情况响应时间的分析。xv6 也不适合软实时(soft real-time)应用——即偶尔错过截止时间也可以接受的情况——因为 xv6 的调度器过于简单,而且它存在某些内核代码路径会长时间禁用中断。
5.6 练习
- 修改 uart.c,让它完全不使用中断。你可能也需要修改 console.c。
- 为网卡添加一个驱动。
第 6 章 锁
包括 xv6 在内的大多数内核,运行时都会交错执行多个活动。造成交错的一个原因是多处理器硬件:拥有多个独立执行的 CPU 的计算机,例如 xv6 所基于的 RISC-V。这些 CPU 共享物理 RAM,xv6 利用这种共享来维护所有 CPU 都会读写的那些数据结构。这种共享带来了一种可能:某个 CPU 正在读取某个数据结构时,另一个 CPU 可能正更新到一半,甚至多个 CPU 同时更新同一份数据。若不经过审慎的设计,这样的并行访问很可能产生错误的结果,或者损坏数据结构。即使在单处理器上,内核也可能在多个线程之间切换 CPU,使它们的执行交错进行。最后,如果某个设备的中断处理程序与某段可被中断的代码修改同一份数据,而中断恰好在错误的时机到来,数据就可能被破坏。并发(concurrency)一词指的正是这种多条指令流因多处理器并行、线程切换或中断而交错执行的情形。
内核中充满了被并发访问的数据。举例来说,两个 CPU 可能同时调用 kalloc,从而并发地从空闲链表的头部弹出元素。内核设计者倾向于允许大量并发,因为这能通过并行带来更高的性能和更快的响应速度。然而也正因如此,内核设计者需要花费大量精力来说服自己:尽管存在这些并发,代码仍是正确的。写出正确的代码有许多途径,其中一些比另一些更容易推理。在并发条件下确保正确性的策略,以及支持这些策略的抽象,统称为并发控制(concurrency control)技术。
xv6 根据不同情况使用多种并发控制技术,实际可能的技巧还有更多。本章聚焦于其中一种被广泛使用的技术:锁(lock)。锁提供互斥(mutual exclusion),保证同一时刻只有一个 CPU 能持有某把锁。如果编程者让每份共享数据都关联一把锁,并且代码在使用某个数据项时总是持有对应的锁,那么这个数据项同一时刻就只会被一个 CPU 使用。在这种情况下,我们说锁保护了这个数据项。尽管锁是一种容易理解的并发控制机制,它的缺点却是可能严重损害性能,因为它会把本可并发的操作串行化。
本章接下来的部分将解释 xv6 为什么需要锁、xv6 如何实现锁,以及 xv6 如何使用锁。
6.1 竞态条件
下面用一个例子来说明为什么我们需要锁:考虑两个进程在两个不同的 CPU 上同时调用 wait 的情形。wait 会释放子进程的内存,因此在每个 CPU 上,内核都会调用 kfree 来释放子进程的内存页。内核分配器维护着一条链表:kalloc()(kernel/kalloc.c:69)从空闲页链表中弹出一页内存,kfree()(kernel/kalloc.c:47)把一页内存压回空闲链表。为了获得最佳性能,我们也许希望两个父进程的 kfree 能并行执行、互不等待,但就 xv6 的 kfree 实现而言,这样做是不正确的。
图 6.1 更详细地展示了这一情景:这条链表位于两个 CPU 共享的内存中,两个 CPU 用 load 和 store 指令来操作它。(实际硬件中处理器带有缓存,但从概念上讲,多处理器系统的行为就像只有一份共享内存一样。)如果没有并发的请求,你可以像下面这样实现链表的 push 操作:
struct element {
  int data;
  struct element *next;
};

struct element *list = 0;

void
push(int data)
{
  struct element *l;

  l = malloc(sizeof *l);
  l->data = data;
  l->next = list;
  list = l;
}
这份实现单独执行时是正确的,然而当多个副本并发执行时就不正确了。如果两个 CPU 同时执行 push,两者都可能如图 6.1 所示,在任一方执行 list = l 之前先执行了 l->next = list,从而产生图 6.2 所示的错误结果:此时会有两个链表节点的 next 都指向 list 原来的值;当两次 list = l 的赋值发生时,第二次赋值会覆盖第一次,第一次赋值涉及的节点就丢失了。
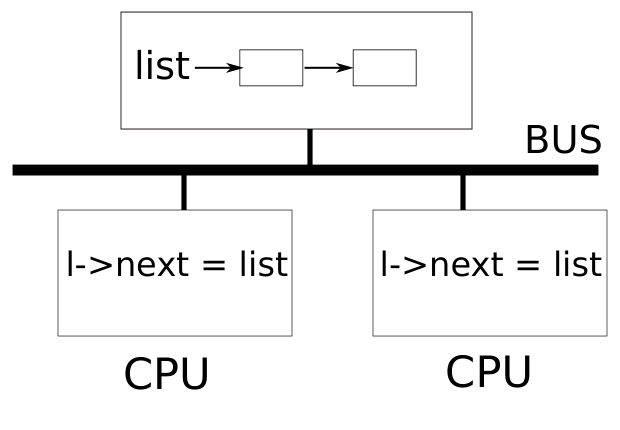
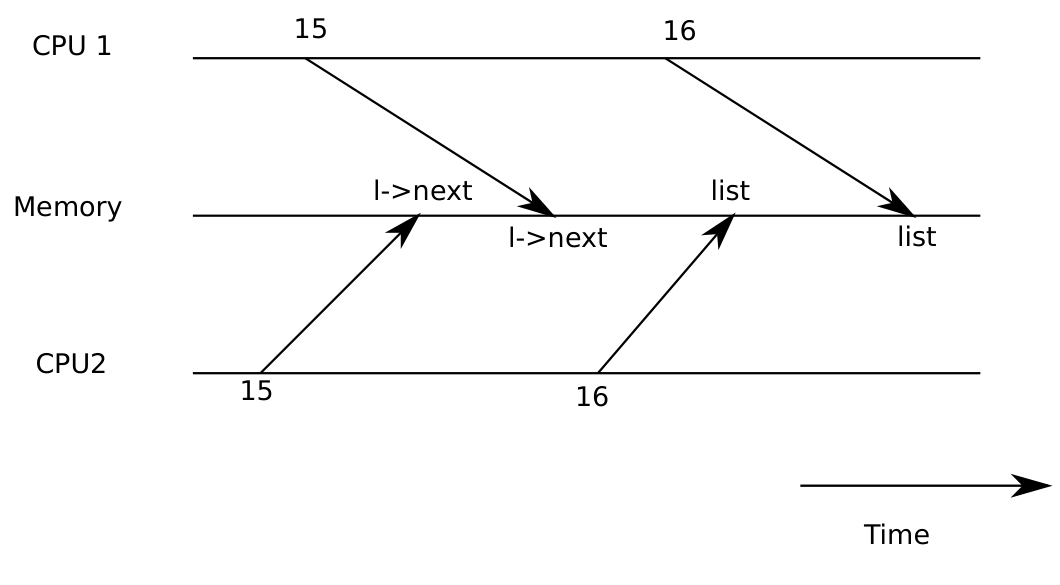
在 list = l 处丢失的更新就是竞态条件(race condition)的一个例子。竞态条件指的是这样一种情形:一个内存位置被并发地访问,并且至少有一个访问是写操作。竞态往往意味着 bug:要么是更新丢失(如果这些访问都是写),要么是读到了只更新了一半的数据结构。竞态的结果取决于相关 CPU 执行的精确时序以及内存系统如何对这些操作排序,这使得竞态引起的错误难以重现和调试。例如,在调试 push 时加入打印语句,可能就足以改变执行时序,让竞态消失。
避免竞态最常用的手段就是锁。锁保证互斥,使同一时刻只有一个 CPU 能执行 push 中那些敏感的代码行,这就让上面那种情形不可能发生。上述代码正确加锁的版本只需增加几行:
struct element *list = 0;
struct lock listlock;  // 新增这一行

void
push(int data)
{
  struct element *l;
  l = malloc(sizeof *l);
  l->data = data;

  acquire(&listlock);  // 新增这一行
  l->next = list;
  list = l;
  release(&listlock);  // 新增这一行
}
acquire 与 release 之间的指令序列常被称为临界区(critical section)。通常我们说这把锁保护着 list。
当我们说一把锁保护某些数据时,实际指的是这把锁保护了作用于这些数据的一组不变式(invariants)。不变式是数据结构在各次操作之间维持不变的性质。通常,一个操作的正确行为依赖于操作开始时不变式成立。操作可以暂时破坏不变式,但必须在结束前重新建立它。例如,在链表的例子中,不变式是:list 指向链表的第一个节点,且每个节点的 next 字段指向下一个节点。push 的实现会暂时破坏这个不变式:在 l->next = list 处,l 已经指向了链表的下一个节点,但 list 还没有指向 l(直到 list = l 才重新建立)。我们前面考察的竞态条件之所以发生,就是因为另一个 CPU 在链表不变式(暂时)失效时执行了依赖这些不变式的代码。正确使用锁可以确保同一时刻只有一个 CPU 能在临界区中操作数据结构,从而不会有 CPU 在数据结构的不变式不成立时执行数据结构操作。
你可以把锁理解为将并发的临界区串行化(serializing),使它们一次只执行一个,从而保住不变式(前提是每个临界区单独执行时是正确的)。你也可以这样理解:受同一把锁保护的各临界区彼此之间是原子的,每个临界区看到的都只是更早临界区完整的改动集合,而永远不会看到只完成了一半的更新。
虽然正确使用锁能让不正确的代码变得正确,锁也会限制性能。例如,如果两个进程并发调用 kfree,锁会把这两个调用串行化,我们就无法从让它们运行在不同 CPU 上得到任何好处。如果多个进程在同一时刻想要同一把锁,我们就说这些进程发生了冲突(conflict),或者说这把锁经历了竞争(contention)。内核设计中的一大挑战就是避免锁竞争。xv6 在这方面做得很少,而复杂的内核会专门组织数据结构与算法来避免锁竞争。在链表的例子中,内核可以为每个 CPU 维护一条空闲链表,只有在本 CPU 的链表已空、必须从别的 CPU 那里“偷”内存时,才会去碰其他 CPU 的空闲链表。其他使用场景可能需要更复杂的设计。
锁的摆放位置对性能也很重要。例如,把 push 中的 acquire 提前是正确的:把对 acquire 的调用上移到 l = malloc(sizeof *l) 之前没有问题。但这可能降低性能,因为这样一来对 malloc 的调用也被串行化了。下面的“锁的使用”一节为在哪里插入 acquire 和 release 提供了一些指导原则。
6.2 代码:锁
xv6 有两种锁:自旋锁(spinlock)和睡眠锁(sleep-lock)。我们先从自旋锁讲起。xv6 用一个 struct spinlock(kernel/spinlock.h:2)来表示自旋锁。这个结构中重要的字段是 locked,它是一个字(word):当锁可用时其值为 0,被持有时其值非 0。从逻辑上讲,xv6 获取一把锁时执行的代码应该像这样:
void
acquire(struct spinlock *lk) // 这样是行不通的!
{
  for(;;) {
    if(lk->locked == 0) {
      lk->locked = 1;
      break;
    }
  }
}
不幸的是,这份实现无法在多处理器上保证互斥。可能两个 CPU 同时到达 if(lk->locked == 0) 这一行,都看到 lk->locked 为 0,然后都通过执行 lk->locked = 1 抢到了锁。此时两个不同的 CPU 都持有着锁,违反了互斥性质。我们需要的是一种方法,能让检查和获取作为一个原子(即不可分割)的步骤执行。
由于锁的使用非常广泛,多核处理器通常都会提供一些指令,来实现“检查并获取”的原子版本。在 RISC-V 上,这条指令是 amoswap r, a。amoswap 读取内存地址 a 处的值,把寄存器 r 的内容写入该地址,并把读到的值放入 r。也就是说,它交换了寄存器和内存地址的内容。它原子性地完成这一序列,并借助特殊硬件防止任何其他 CPU 在这次读和写之间使用该内存地址。
xv6 的 acquire(kernel/spinlock.c:22)使用了可移植的 C 库函数 __sync_lock_test_and_set,它最终会归结为 amoswap 指令;其返回值是 lk->locked 原来的(被换出的)内容。acquire 函数把这个 swap 操作包在一个循环里,不断重试(自旋),直到获得锁为止。每次迭代都把 1 换入 lk->locked 并检查此前的值;如果此前的值是 0,说明我们获得了锁,且这次 swap 已把 lk->locked 设为 1。如果此前的值是 1,说明其他某个 CPU 持有这把锁,而我们原子地把 1 换入 lk->locked 并不会改变它的值。
获得锁之后,为了便于调试,acquire 会记录获取锁的 CPU。lk->cpu 字段受该锁保护,只能在持有锁时修改。
函数 release(kernel/spinlock.c:47)与 acquire 相反:它先清除 lk->cpu 字段,然后释放锁。从概念上讲,释放锁只需把 0 赋给 lk->locked。但 C 标准允许编译器用多条 store 指令来实现一次赋值,因此就并发代码而言,C 的赋值可能是非原子的。于是 release 改用 C 库函数 __sync_lock_release,它执行一次原子赋值。这个函数最终同样归结为 RISC-V 的 amoswap 指令。
6.3 代码:锁的使用
xv6 在许多地方使用锁来避免竞态条件。如前所述,kalloc(kernel/kalloc.c:69)和 kfree(kernel/kalloc.c:47)就是一个很好的例子。你可以试试练习 1 和练习 2,看看这两个函数省略锁之后会发生什么。你可能会发现很难触发不正确的行为,这表明要可靠地测试代码是否没有锁错误和竞态是很困难的。xv6 自己也可能存在一些尚未发现的竞态。
使用锁的难点之一,在于决定用多少把锁,以及每把锁应该保护哪些数据和不变式。这里有几条基本原则。第一,只要一个变量可能被一个 CPU 写入,同时可能被另一个 CPU 读取或写入,就应该用锁来防止这两个操作重叠。第二,记住锁保护的是不变式:如果一个不变式涉及多个内存位置,通常所有这些位置都需要由同一把锁来保护,才能确保不变式得到维持。
上面的规则说明了什么时候需要锁,却没有说明什么时候不需要锁;而为了效率,不过度加锁很重要,因为锁会降低并行性。如果并行性不重要,可以只安排一个线程,根本不必操心锁的事。一个简单的内核在多处理器上也可以这样做:进入内核时获取一把锁,退出内核时释放它(不过像管道读、wait 这样的系统调用就会有问题)。许多单处理器操作系统就是用这种办法移植到多处理器上的,这种做法有时被称为“大内核锁”(big kernel lock),但它牺牲了并行性:同一时刻只有一个 CPU 能在内核中执行。如果内核要做大量计算,更高效的做法是使用数量更多、粒度更细的锁,让内核能同时在多个 CPU 上执行。
作为粗粒度(coarse-grained)加锁的一个例子,xv6 的 kalloc.c 分配器用一个锁保护着一条空闲链表。如果不同 CPU 上的多个进程同时试图分配页,每个进程都得在 acquire 中自旋等待轮到自己。自旋会降低性能,因为它不是有用的工作。如果对这把锁的竞争浪费了很大一部分 CPU 时间,也许可以改进分配器的设计来提升性能:改用多条空闲链表,每条各有自己的锁,从而实现真正的并行分配。
作为细粒度(fine-grained)加锁的一个例子,xv6 为每个文件设置一把单独的锁,于是操作不同文件的进程常常无须互相等待对方的锁。如果希望允许进程同时写入同一文件的不同区域,文件加锁方案还可以做得更细。归根结底,锁粒度的取舍既要由性能测量驱动,也要考虑复杂度。
后续章节在讲解 xv6 各部分时,会提到 xv6 用锁处理并发的例子。作为预告,图 6.3 列出了 xv6 中所有的锁。
图 6.3 xv6 中的锁
| 锁 | 描述 |
|---|---|
bcache.lock |
保护块缓冲区缓存项的分配 |
cons.lock |
串行化对控制台硬件的访问,避免输出交错混杂 |
ftable.lock |
串行化文件表中 struct file 的分配 |
itable.lock |
保护内存中 inode 表项的分配 |
vdisk_lock |
串行化对磁盘硬件及 DMA 描述符队列的访问 |
kmem.lock |
串行化内存的分配 |
log.lock |
串行化对事务日志的操作 |
pipe 的 pi->lock |
串行化对每个管道的操作 |
pid_lock |
串行化对 next_pid 的递增 |
proc 的 p->lock |
串行化对进程状态的更改 |
wait_lock |
帮助 wait 避免丢失唤醒 |
tickslock |
串行化对 ticks 计数器的操作 |
inode 的 ip->lock |
串行化对每个 inode 及其内容的操作 |
buf 的 b->lock |
串行化对每个块缓冲区的操作 |
6.4 死锁与加锁顺序
如果内核中某条代码路径必须同时持有若干把锁,那么所有代码路径就必须以相同的顺序获取这些锁。若非如此,就有死锁的风险。假设 xv6 中两条代码路径都需要锁 A 和锁 B,但路径 1 按先 A 后 B 的顺序获取,而路径 2 按先 B 后 A 的顺序获取。假设线程 T1 执行路径 1 并获得了锁 A,线程 T2 执行路径 2 并获得了锁 B。接下来 T1 会尝试获取锁 B,T2 会尝试获取锁 A。两次 acquire 都会无限期阻塞,因为无论哪个线程,对方都持有自己需要的锁,而且在它的 acquire 返回之前不会释放它。为了避免这样的死锁,所有代码路径必须以相同的顺序获取锁。对全局锁获取顺序的要求意味着,锁实际上是每个函数规约(specification)的一部分:调用者必须以让锁按约定顺序被获取的方式来调用函数。
由于 sleep 的工作方式(见第 7 章),xv6 中有许多长度为 2 的锁顺序链(lock-order chain),它们涉及每进程锁(每个 struct proc 中的锁)。例如,consoleintr(kernel/console.c:136)是处理键入字符的中断例程。当换行符到来时,所有等待控制台输入的进程都应被唤醒。为此,consoleintr 在持有 cons.lock 的情况下调用 wakeup,后者会获取等待进程的锁以便唤醒它。因此,全局的避免死锁的锁顺序中包含这样一条规则:必须先获取 cons.lock,然后才能获取任何进程锁。文件系统代码中包含 xv6 最长的锁链。例如,创建一个文件需要同时持有:目录上的锁、新文件 inode 上的锁、某个磁盘块缓冲区上的锁、磁盘驱动的 vdisk_lock,以及调用进程的 p->lock。为了避免死锁,文件系统代码总是按前一句所说的顺序获取这些锁。
遵守一种全局的、避免死锁的锁顺序,可能出人意料地困难。有时锁顺序会与程序的逻辑结构冲突,例如模块 M1 调用模块 M2,而锁顺序却要求先获取 M2 中的锁,再获取 M1 中的锁。有时无法事先知道要获取的锁是哪一把,也许是因为必须先持有某把锁,才能查明下一把要获取的锁是什么。这种情形会出现在文件系统逐级查找路径名中各个组成部分的时候,也会出现在 wait 与 exit 在进程表中搜索子进程的时候。最后,死锁的危险常常限制了加锁方案的粒度能做多细,因为锁越多往往意味着死锁的机会越多。如何避免死锁,常常是内核实现中的一个主要考虑因素。
6.5 可重入锁
乍看之下,某些死锁和锁顺序难题似乎可以用可重入锁(re-entrant locks,也称为递归锁)来避免。其想法是:如果一把锁已被某个进程持有,而这个进程再次尝试获取它,内核可以直接允许(因为这个进程本来就已经持有该锁),而不像 xv6 内核那样调用 panic。
然而事实证明,可重入锁让并发推理变得更困难:可重入锁破坏了“锁使临界区相对于其他临界区是原子的”这一直觉。来看看下面这两个函数 f 和 g:
struct spinlock lock;
int data = 0; // 由 lock 保护

f() {
  acquire(&lock);
  if(data == 0){
    call_once();
    h();
    data = 1;
  }
  release(&lock);
}

g() {
  acquire(&lock);
  if(data == 0){
    call_once();
    data = 1;
  }
  release(&lock);
}
看着这段代码,直觉上 call_once 只会被调用一次:要么被 f 调用,要么被 g 调用,不会两者都调用。但如果允许可重入锁,而 h 恰好调用了 g,call_once 就会被调用两次。
如果不允许可重入锁,h 调用 g 就会导致死锁,这同样不妙。但假设调用两次 call_once 是个严重错误,死锁反而更好:内核开发者会注意到死锁(内核 panic),从而修复代码避免它;而 call_once 被调用两次则可能悄无声息地造成一个难以追查的错误。
出于这个原因,xv6 使用更容易理解的非可重入锁。不过,只要编程者把加锁规则记在心里,两种做法都是可行的。如果 xv6 要使用可重入锁,就必须修改 acquire,让它察觉到锁当前已被调用它的线程持有;还必须向 struct spinlock 中加入一个嵌套 acquire 的计数,其风格与下面要讨论的 push_off 类似。
6.6 锁与中断处理程序
xv6 的一些自旋锁保护着同时被线程和中断处理程序使用的数据。例如,时钟中断处理程序 clockintr 可能会在某个内核线程于 sys_sleep(kernel/sysproc.c:64)中读取 ticks(kernel/trap.c:163)的同时,尝试给 ticks 加一。锁 tickslock 将这两个访问串行化。
自旋锁与中断的交互会带来潜在的危险。假设 sys_sleep 持有 tickslock 时,它的 CPU 被一次时钟中断打断。clockintr 会尝试获取 tickslock,发现它已被持有,于是等待其释放。但在这种情形下,tickslock 永远不会被释放:只有 sys_sleep 能释放它,而 clockintr 返回之前 sys_sleep 不会继续运行。于是这个 CPU 会死锁,任何需要这把锁的代码也都会随之冻结。
为了避免这种情形,如果一把自旋锁会被中断处理程序使用,那么 CPU 绝不能在开着中断时持有这把锁。xv6 的做法更保守:当 CPU 获取任何锁时,xv6 总是会关闭该 CPU 上的中断。中断仍然可以在其他 CPU 上发生,因此中断处理程序的 acquire 可以等待某个线程释放自旋锁,只是不能在同一个 CPU 上这样做。
当 CPU 不再持有任何自旋锁时,xv6 会重新打开中断;为了应对嵌套的临界区,它必须做一点簿记工作。acquire 调用 push_off(kernel/spinlock.c:89),release 调用 pop_off(kernel/spinlock.c:100),以此追踪当前 CPU 上锁的嵌套层数。当这个计数归零时,pop_off 会恢复进入最外层临界区之前存在的中断使能状态。intr_off 和 intr_on 函数分别执行 RISC-V 指令来关闭和打开中断。
很重要的一点是,acquire 必须严格在设置 lk->locked(kernel/spinlock.c:28)之前调用 push_off。如果两者的顺序颠倒,就会出现一个短暂的窗口:锁已被持有,但中断还开着,一次时机不巧的中断就会让系统死锁。类似地,release 必须只在释放锁之后才调用 pop_off(kernel/spinlock.c:66)。
6.7 指令与内存顺序
人们很自然地认为程序会按照源代码中语句出现的顺序执行。然而,许多编译器和 CPU 为了获得更高的性能会乱序执行代码。如果一条指令需要很多个周期才能完成,CPU 可能会提前发出这条指令,让它与其他指令重叠执行,从而避免 CPU 停顿(stall)。例如,CPU 可能会注意到指令序列中的指令 A 和 B 互不依赖,于是先启动指令 B——这可能是因为 B 的输入比 A 的输入更早就绪,也可能是为了让 A 和 B 的执行重叠。编译器也可能做类似的重排:为某个语句生成的指令,可能被发射在源代码中位于它之前的语句的指令之前。
编译器和 CPU 在重排时遵循一些规则,以确保不会改变正确编写的串行代码的结果。然而,这些规则确实允许那些会改变并发代码结果的重排,并且很容易在多处理器上导致错误行为[3][9]。CPU 的排序规则称为内存模型(memory model)。
例如,下面这份 push 的代码中,如果编译器或 CPU 把第 4 行对应的 store 移动到第 6 行的 release 之后,那就是一场灾难:
l = malloc(sizeof *l);
l->data = data;
acquire(&listlock);
l->next = list;   // 第 4 行
list = l;
release(&listlock);  // 第 6 行
如果发生了这样的重排,就会出现一个时间窗口:另一个 CPU 可能在这期间获取锁并观察到已更新的 list,但看到的 list->next 却尚未初始化。
为了告诉硬件和编译器不要做这样的重排,xv6 在 acquire(kernel/spinlock.c:22)和 release(kernel/spinlock.c:47)中都使用了 __sync_synchronize()。__sync_synchronize() 是一个内存屏障(memory barrier):它告诉编译器和 CPU 不要让 load 或 store 跨越屏障重排。xv6 的 acquire 和 release 中的这些屏障,在几乎所有要紧的场合都强制了顺序,因为 xv6 对共享数据的访问都包在锁里。第 9 章将讨论少数例外情形。
6.8 睡眠锁
有时 xv6 需要长时间持有一把锁。例如,文件系统(第 8 章)在磁盘上读写文件内容期间会保持该文件上锁,而磁盘操作可能要花几十毫秒。如果一把自旋锁被持有这么久,就会造成浪费:想获取它的另一个进程会在长时间的自旋中浪费 CPU。自旋锁的另一个缺点是,进程在持有自旋锁时不能让出 CPU;而我们希望能让出,好让持锁进程等待磁盘时,其他进程能用上 CPU。持有自旋锁时让出 CPU 是不合法的,因为如果第二个线程随后尝试获取这把自旋锁,就可能死锁:acquire 不会让出 CPU,第二个线程的自旋可能会阻止第一个线程运行并释放锁。持锁时让出 CPU 还会违反“持有自旋锁期间必须关闭中断”这一要求。因此,我们需要这样一种锁:在等待获取时能让出 CPU,在被持有期间也允许让出(以及允许中断)。
xv6 以睡眠锁的形式提供了这样的锁。acquiresleep(kernel/sleeplock.c:22)在等待期间让出 CPU,所用技术将在第 7 章解释。概括地说,睡眠锁有一个 locked 字段,由一把自旋锁保护,acquiresleep 对 sleep 的调用会原子地让出 CPU 并释放自旋锁。其结果是,在 acquiresleep 等待时,其他线程仍能执行。
由于睡眠锁不关闭中断,它们不能在中断处理程序中使用。由于 acquiresleep 可能会让出 CPU,睡眠锁也不能用在自旋锁的临界区内部(不过自旋锁可以用在睡眠锁的临界区内部)。
自旋锁最适合短的临界区,因为等待它们会浪费 CPU 时间;睡眠锁则适合耗时的操作。
6.9 现实世界
尽管对并发原语与并行计算已有多年的研究,用锁编程仍然很有挑战。通常,最好的做法是把锁隐藏在诸如同步队列这样的高层构造之中,尽管 xv6 没有这样做。如果你要用锁编程,明智的做法是使用能够检测竞态条件的工具,因为很容易漏掉某个需要锁来保护的不变式。
大多数操作系统都支持 POSIX 线程(Pthreads),它允许一个用户进程拥有多个在不同 CPU 上并发运行的线程。Pthreads 支持用户级的锁、屏障(barrier)等。Pthreads 还允许编程者自行指定某把锁是否可重入。
在用户级支持 Pthreads 需要操作系统的支持。例如,如果一个 pthread 在系统调用中阻塞,同一进程的其他 pthread 应当仍能在那个 CPU 上运行。又如,如果一个 pthread 改变了其进程的地址空间(例如映射或取消映射内存),内核必须让运行该进程线程的其他 CPU 更新它们的硬件页表,以反映地址空间的这一变化。
不使用原子指令来实现锁是可能的[9],但代价高昂,因此大多数操作系统都使用原子指令。
当许多 CPU 同时尝试获取同一把锁时,锁可能变得代价高昂。如果一个 CPU 把锁缓存在它的本地缓存中,而另一个 CPU 必须获取这把锁,那么更新锁所在缓存行的原子指令必须把这行缓存从一个 CPU 的缓存移到另一个 CPU 的缓存中,并可能使其他缓存副本失效。从另一个 CPU 的缓存中取一个缓存行,可能比从本地缓存中取贵若干个数量级。
为了避免与锁相关的开销,许多操作系统使用了无锁(lock-free)的数据结构与算法[5][11]。例如,可以实现一个像本章开头那样的链表:查找时完全不需要锁,向链表插入一项只需一条原子指令。然而,无锁编程比用锁编程更复杂,例如必须考虑指令与内存重排。用锁编程本来就够难了,所以 xv6 避免了无锁编程带来的额外复杂性。
6.10 练习
- 注释掉
kalloc(kernel/kalloc.c:69)中对acquire和release的调用。这似乎会给调用kalloc的内核代码带来问题;你预期会看到什么症状?运行 xv6 时你真的看到这些症状了吗?运行usertests时呢?如果你没有看到问题,为什么?试着在kalloc的临界区中插入一些空循环,看看能否引发问题。 - 假设你转而注释掉
kfree中的加锁(在恢复kalloc的加锁之后)。这时可能出什么问题?kfree缺少锁的危害比kalloc小吗? - 如果两个 CPU 同时调用
kalloc,其中一个必须等待另一个,这对性能是有害的。修改 kalloc.c,使其具有更多并行性,让不同 CPU 对kalloc的同时调用可以无需互相等待地推进。 - 使用 POSIX 线程编写一个并行程序(大多数操作系统都支持)。例如,实现一个并行哈希表,并测量 put/get 的数量是否随核数的增加而扩展。
- 在 xv6 中实现 Pthreads 的一个子集。也就是说,实现一个用户级线程库,使一个用户进程可以拥有不止一个线程,并安排这些线程可以在不同 CPU 上并行运行。请设计出一套能正确处理线程发起阻塞系统调用以及修改共享地址空间的方案。
第 7 章 调度
任何操作系统在运行时,通常会有比电脑实际拥有的 CPU 数量还多的进程,因此必须有一套计划来让这些进程能够轮流使用 CPU。理想情况下,这种共享对用户进程而言应当是透明的。常见的做法是通过多路复用(multiplexing),把多个进程映射到实际的硬件 CPU 上,让每个进程产生拥有自己虚拟 CPU 的错觉。本章会说明 xv6 是如何实现这样的多路复用的。
7.1 多路复用
xv6 的多路复用机制会在两种情况下让某个 CPU 从一个进程切换到另一个。第一种是 xv6 的 sleep 与 wakeup 机制引起的切换:当进程等待设备或管道 I/O 完成、等待子进程退出,或在 sleep 系统调用中等待时,就会发生切换。第二种是为了应对那些长时间运算而不会睡眠的进程,xv6 会定期强制让 CPU 切换到其他进程。通过这些切换,xv6 创造出每个进程各自拥有一颗 CPU 的错觉,正如 xv6 用内存分配器和硬件页表创造出每个进程各自拥有自己的内存的错觉一样。
要实现多路复用有几个挑战:
- 第一,该如何从一个进程切换到另一个?
- 上下文切换的概念很简单,但它的实现是 xv6 中最晦涩的代码之一
- 第二,该如何让“强制切换”对用户进程来说是透明的?
- xv6 采用了一个标准技巧,由硬件时钟触发的中断来驱动上下文切换
- 第三,由于所有 CPU 都会在同一组共享的进程之间切换,因此必须设计一套锁定策略以避免竞态条件
- 第四,当一个进程结束时,它的内存与其他资源必须被释放,但进程自己无法完成这些释放动作
- 例如进程无法在其还在使用内核栈的情况下释放那块栈,需要其他线程帮它收尾
- 第五,对于多核机器,每颗 CPU 都必须记住自己目前正在运行哪个进程,这样系统调用才能正确地作用在那个进程的内核状态上
- 最后,
sleep和wakeup机制允许进程放弃 CPU,并等待其他进程或中断将它唤醒,而这里需要特别小心,避免竞态条件导致唤醒通知被遗失
xv6 试图尽可能简单地解决这些问题,但由此得到的代码仍然很棘手。
7.2 代码:上下文切换
图 7.1 概述了从一个用户进程切换到另一个进程所经历的步骤:一次从用户空间到内核的转换(系统调用或中断)进入旧进程的内核线程;一次上下文切换到目前 CPU 的调度器线程;再一次上下文切换到新进程的内核线程;最后通过陷入返回(trap return)回到新的用户级进程。
xv6 为调度器使用了独立的线程(各自拥有寄存器与栈的保存空间),因为让调度器在任意进程的内核栈上运行并不安全:其他 CPU 可能会在这段期间唤醒该进程并开始运行,若两个 CPU 共用同一个栈,会造成灾难性的后果。为了处理多个 CPU 同时运行、并有进程要放弃 CPU 的情况,xv6 为每个 CPU 配置了独立的调度器线程。在这一节中,我们将会详细探讨内核线程与调度器线程之间切换的具体实现方式。
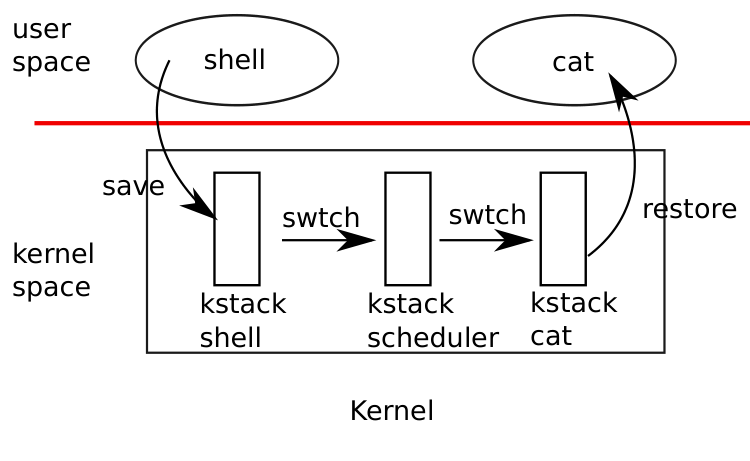
从一个线程切换到另一个线程的过程,需要将旧线程的 CPU 寄存器保存下来,并还原新线程先前保存的那些寄存器。由于栈指针(stack pointer)和程序计数器(program counter)都会被保存与还原,这也表示 CPU 将会切换至新的栈,并且运行新的代码。
swtch 函数负责保存与还原寄存器,实现内核线程间的切换。swtch 并不直接知道所谓的“线程”是什么,它只负责保存与还原一组 32 个 RISC-V 寄存器,这样的寄存器集合被称作上下文(context)。当某个进程要放弃 CPU 时,它的内核线程会调用 swtch,把自己的上下文保存起来,并还原调度器的上下文。
每个上下文都存在 struct context(kernel/proc.h:2)里,这个结构会被放在某个进程的 struct proc 或某个 CPU 的 struct cpu 中。swtch 会接收 struct context *old 和 struct context *new 这两个参数,并将目前的寄存器保存到 old,从 new 中加载先前保存的寄存器,然后返回。
现在让我们来追踪一个进程如何通过 swtch 切换进入 scheduler 的。在第 4 章中我们看到,中断的结束阶段中有一种情况是 usertrap 调用 yield。而 yield 接着会调用 sched,sched 再调用 swtch,把目前的上下文存到 p->context 中,并切换到先前保存在 cpu->context 的调度器上下文(kernel/proc.c:490)。
swtch(kernel/swtch.S:3)只会保存被调用者保存寄存器(callee-saved registers),而调用者保存寄存器(caller-saved registers)则会由 C 编译器在调用端负责保存到栈上。swtch 知道每个寄存器对应到 struct context 中的哪个成员,以及该成员的偏移量。它不会保存程序计数器,而是保存 ra 寄存器,这个寄存器中存放的是调用 swtch 那一行指令的返回地址(return address)。
接着,swtch 从新的上下文还原寄存器,这些值是先前某次 swtch 保存的。当 swtch 通过 ret 返回时,它会回到还原后的 ra 所指向的那行指令,也就是新线程先前调用 swtch 的那个位置。同时,因为 sp 已被还原为新线程的栈指针,因此运行也会从新线程的栈上继续。
在我们这个例子中,sched 会调用 swtch,并切换到 cpu->context,也就是这颗 CPU 专属的调度器上下文。这份上下文是在先前某个时刻,由调度器调用 swtch 并切换到现在这个进程时所保存的(kernel/proc.c:456)。所以当我们目前追踪的这次 swtch 返回时,它实际上不是回到 sched,而是回到调度器,而且此时栈指针已经是这颗 CPU 的调度器栈了。
7.3 代码:调度
上一节我们探讨了 swtch 的底层细节;现在我们把 swtch 当作已知,来观察一个进程的内核线程是如何通过调度器切换到另一个进程的。调度器以每颗 CPU 上一个特殊线程的形式存在,这个线程运行的是 scheduler 函数。这个函数会负责选出下一个要运行的进程。当某个进程想放弃 CPU 时,它必须先取得自己的进程锁 p->lock,释放它持有的其他锁,更新自己的状态(p->state),然后调用 sched。你可以在 yield(kernel/proc.c:496)、sleep 和 exit 中看到这个流程。
接着 sched 会再次确认这些条件是否已被满足(kernel/proc.c:480-485),并检查一个隐含的条件:既然持有锁,则必须确保中断已被关闭。最后,sched 调用 swtch,将当前的上下文存入 p->context,并切换到 cpu->context 中的调度器上下文。swtch 返回时会回到调度器的栈,就好像当初调度器调用的 swtch 返回了一样(kernel/proc.c:456)。然后调度器继续它的 for 循环,找下一个进程来运行,再切换过去,如此反复循环。
我们刚刚看到 xv6 在调用 swtch 的整个过程中会持续持有 p->lock:调用 swtch 的代码必须事先持有这把锁,并且这把锁的控制权会一并传给被切换过去的代码。这样的安排并不常见:更常见的做法是持有锁的一方同时负责释放它,这样也更容易推理正确性。但 xv6 不能这样做,因为 p->lock 保护了进程的 p->state 与 p->context 字段的不变式,而这些不变式在运行 swtch 的时候会被暂时破坏掉。
例如,如果在运行 swtch 期间没有持有 p->lock,那么另一颗 CPU 可能会在 yield 将进程状态设为 RUNNABLE 之后、但 swtch 还没让它停止使用自己的内核栈之前,就抢先运行这个进程,导致两个 CPU 同时在用同一个栈,造成灾难。
因此,一旦 yield 开始修改进程的状态,使它变成 RUNNABLE,那就必须持续持有 p->lock,直到系统恢复状态一致为止:最早能释放锁的时间点是在调度器(它使用自己的栈运行)清除 c->proc 之后。反过来说,当调度器开始把某个 RUNNABLE 进程转换成 RUNNING 时,也不能在 swtch 之前释放锁,而是要等到进程的内核线程真正开始运行(例如在 yield 里)之后才行。
内核线程唯一会放弃 CPU 的地方是在 sched,而它总会切换回调度器中的同一处位置,然后调度器几乎又总会切换到某个先前调用过 sched 的内核线程。因此,如果你打印 xv6 切换线程所在的行号,你会看到一个很简单的模式:kernel/proc.c:456、kernel/proc.c:490、kernel/proc.c:456、kernel/proc.c:490,这样反复。这种通过线程切换有意地把控制权交给彼此的程序,有时被称作协程(coroutines);在这个例子中,sched 和 scheduler 就是彼此的协程。
有一种情况下,调度器调用 swtch 后不会进入 sched。allocproc 会把新进程的上下文中的 ra 设为 forkret(kernel/proc.c:508),这样这个进程第一次被切入时,swtch 就会“返回”到那个函数的开头。forkret 的存在是为了释放 p->lock;否则,因为这个新进程需要回到用户空间(就像从 fork 返回一样),它本来可以直接从 usertrapret 开始运行。
调度器(kernel/proc.c:438)会跑一个无限循环:找出一个可运行的进程,运行它直到它让出 CPU,再重复这个流程。调度器会遍历整个进程表,寻找状态为 RUNNABLE 的进程。一旦找到,它会设置这颗 CPU 的 c->proc 指针,将该进程的状态设为 RUNNING,然后调用 swtch 开始运行它(kernel/proc.c:451-456)。
可以从另一个角度来看待调度代码的结构:它为每个进程维持着一组不变式,并且在这些不变式不成立期间始终持有 p->lock。其中一条不变式是:如果一个进程处于 RUNNING,那么时钟中断引发的 yield 必须能够安全地从这个进程切换走;这意味着 CPU 寄存器中必须保持着该进程的寄存器值(也就是说 swtch 还没把它们搬进上下文),并且 c->proc 必须指向该进程。另一条不变式是:如果一个进程是 RUNNABLE,那么空闲 CPU 上的调度器运行它必须是安全的;这意味着进程的寄存器必须保存在 p->context 中(也就是说它们并不真的在 CPU 寄存器里),没有 CPU 正在该进程的内核栈上执行,并且任何 CPU 的 c->proc 都不指向该进程。请注意,这些性质在持有 p->lock 期间往往是不成立的。
维持上述不变式,正是 xv6 常常在一个线程中获取 p->lock、却在另一个线程中释放它的原因,例如在 yield 中获取、在调度器中释放。
7.4 代码:mycpu 与 myproc
xv6 经常需要取得目前正在运行的进程所对应的 proc 结构的指针。在单核系统中,可以使用一个全局变量来指向当前的 proc。但这在多核机器上就行不通了,因为每个 CPU 都可能在运行不同的进程。解决这个问题的办法是利用“每颗 CPU 都拥有自己独立的一组寄存器”这一事实,并用其中一个寄存器来帮助找到每颗 CPU 各自的信息。
当某颗 CPU 正在运行内核代码时,xv6 保证这颗 CPU 的 tp 寄存器会保存它的 hartid。RISC-V 为每颗 CPU 指派了一个唯一的 hartid。mycpu 函数(kernel/proc.c:72)会使用 tp 来索引 struct cpu 的数组,并返回指向目前这颗 CPU 的 struct cpu 的指针。struct cpu(kernel/proc.h:22)中包含了一个指向当前正在这颗 CPU 上运行的 struct proc 的指针(若有的话)、这颗 CPU 所对应的调度器线程的寄存器快照、以及用来管理中断关闭的自旋锁嵌套层数。
要让每颗 CPU 的 tp 保持对应的 hartid,其实需要一点额外处理,因为用户程序是可以随意修改 tp 的。start 函数会在 CPU 的开机过程早期、仍处于机器模式时设置 tp(kernel/start.c:51)。usertrapret 会把 tp 保存在 trampoline 页中,以防用户程序改动了它。最后,uservec 在从用户空间进入内核时会还原之前保存的 tp(kernel/trampoline.S:70)。编译器保证在内核代码中永远不会去修改 tp。如果 xv6 可以直接向 RISC-V 硬件查找目前的 hartid 会更方便,但 RISC-V 规范中只有机器模式才能这么做,特权模式不行。
cpuid 和 mycpu 的返回值比较脆弱(fragile),如果在这之后发生时钟中断,导致目前这条线程放弃 CPU,然后稍后被排到另一颗 CPU 上运行,那么原先返回的值就会失效。为了避免这个问题,xv6 要求调用这些函数的代码在使用期间必须先关闭中断,等到使用完毕后再重新打开。
函数 myproc(kernel/proc.c:80)会返回目前正在当前 CPU 上运行的进程的 struct proc 指针。myproc 在运行过程中会先关闭中断,接着调用 mycpu,从 struct cpu 中取得目前的 c->proc,最后再重新打开中断。myproc 的返回值在中断打开的情况下也可以安全使用:即使时钟中断将目前的进程移动到另一颗 CPU,指向这个进程的 struct proc 指针仍然是同一个。
7.5 sleep 与 wakeup
调度与锁有助于把一个线程的行为对其他线程隐藏起来,但我们也需要一些抽象工具来让线程之间可以有意识地交互。举例来说,xv6 中管道的读取端可能需要等待写入端产生数据;父进程调用 wait 时可能要等子进程结束;而一个读磁盘的进程则需要等待磁盘设备完成数据读取。
xv6 内核在这些(以及其他许多)情境中会使用名为 sleep 与 wakeup 的机制。sleep 让内核线程可以等待特定事件;而另一个线程则可以调用 wakeup 来通知等待某个事件的线程可以继续运行了。sleep 和 wakeup 常被称为“顺序协调(sequence coordination)”或“条件同步(conditional synchronization)”机制。
sleep 和 wakeup 提供的是一种相对底层的同步接口。为了说明它们在 xv6 中的运作方式,我们将使用它们来构建一个较高层级的同步机制,称为信号量(semaphore),用来协调生产者与消费者(但 xv6 并未实际使用信号量)。一个信号量会维护一个计数器,并提供两种操作:V 操作(由生产者使用)会将计数器加一;P 操作(由消费者使用)会等计数器变为非零值,然后将其减一并返回。假设只有一个生产者线程与一个消费者线程,其分别在不同的 CPU 上运行,并且编译器没有做过度优化,那么以下的实现将是正确的:
struct semaphore {
  struct spinlock lock;
  int count;
};

void
V(struct semaphore *s)
{
  acquire(&s->lock);
  s->count += 1;
  release(&s->lock);
}

void
P(struct semaphore *s)
{
  while(s->count == 0)
    ;
  acquire(&s->lock);
  s->count -= 1;
  release(&s->lock);
}
但上述的实现开销很大。若生产者很少会被运行,消费者就会把大部分的时间花在 while 循环中自旋,等待 count 变成非零值。消费者所占用的 CPU 应该可以用来做更有生产力的事,而不是通过不断轮询 s->count 来忙等。若要避免这种忙等,我们就需要让消费者能够让出 CPU,等到 V 把 count 加一后才再回来继续运行。
尽管这样还不够完善,但这正是往前的第一步。设想有一对名为 sleep 和 wakeup 的函数,其行为如下:sleep(chan) 会等待一个由 chan 这个任意值所指定的事件,这个值被称为“等待信道(wait channel)”。sleep 会让调用它的进程进入睡眠状态,并释放 CPU 让其他工作可以运行。wakeup(chan) 则会唤醒所有正在对相同 chan 调用 sleep 的进程(如果有的话),让那些 sleep 函数返回。如果没有进程正在等待该 chan,则 wakeup 不会有任何效果。
现在我们可以利用 sleep 与 wakeup 来修改信号量的实现:
void
V(struct semaphore *s)
{
  acquire(&s->lock);
  s->count += 1;
  wakeup(s);  // 新增行
  release(&s->lock);
}

void
P(struct semaphore *s)
{
  while(s->count == 0)
    sleep(s);   // 新增行
  acquire(&s->lock);
  s->count -= 1;
  release(&s->lock);
}
现在 P 不再自旋了,其会让出 CPU,这是个好改进。不过要用这种接口正确实现 sleep 和 wakeup 并不容易,因为我们会遇到一种称为“唤醒遗失(lost wakeup)”的问题。假设 P 在 while(s->count == 0) 处发现 s->count == 0,但就在 P 运行完第 13 行、准备运行第 14 行时,V 在另一个 CPU 上被运行了,此时 V 将 s->count 改为了非零值,并调用了 wakeup,但此时尚未有任何进程在睡眠中,因此 wakeup 就没有做任何事。
接着 P 继续运行到第 14 行,调用了 sleep 并进入了睡眠状态。这就造成了一个问题:P 此时正在等待一个已经由 V 发完的 wakeup 调用。除非我们运气很好,生产者再次调用了 V,否则消费者将会被永远卡住,即使 count 已经是非零值了。
这个问题的根源在于,一个重要的不变式被破坏了:P 只会在 s->count == 0 的时候才去 sleep。但这个不变式在 V 刚好于错误时机运行时会被破坏。有一种错误的解法,是试图通过把 P 里面取得锁的动作往前移,让 count 的检查与调用 sleep 的过程变成原子操作:
void
V(struct semaphore *s)
{
  acquire(&s->lock);
  s->count += 1;
  wakeup(s);
  release(&s->lock);
}

void
P(struct semaphore *s)
{
  acquire(&s->lock);        // <--- 错误方式
  while(s->count == 0)
    sleep(s);
  s->count -= 1;
  release(&s->lock);
}
我们希望这个版本的 P 能避免唤醒遗失,因为锁阻止了 V 在 while(s->count == 0) 与 sleep(s) 之间插入运行。它确实做到了这点,但也同时导致了死锁:P 在进入 sleep 时仍持有锁,导致 V 永远无法取得锁而被卡住。
我们将通过改变 sleep 的接口来修正先前的设计问题:调用者必须把“条件锁(condition lock)”传递给 sleep,让 sleep 可以在调用者被标记为睡眠、并在指定的等待信道上等待之后释放这把锁。这把锁会强制让同时运行的 V 延后运行,直到 P 完成进入睡眠,这样 wakeup 才能正确找到处于睡眠状态的消费者并唤醒它。一旦消费者再次被唤醒,sleep 会在返回前重新取得这把锁。经过这种修正后的 sleep/wakeup 机制可以如下列方式使用:
void
V(struct semaphore *s)
{
  acquire(&s->lock);
  s->count += 1;
  wakeup(s);
  release(&s->lock);
}

void
P(struct semaphore *s)
{
  acquire(&s->lock);
  while(s->count == 0)
     sleep(s, &s->lock);  // <--- 改版后的 sleep 会接受一个锁参数
  s->count -= 1;
  release(&s->lock);
}
P 在进入 sleep 前就已经持有了 s->lock,这使得 V 无法在 P 检查 s->count 和调用 sleep 之间插入并尝试唤醒 P。然而,sleep 仍必须以“对 wakeup 来说是原子的方式”,同时释放 s->lock 并让消费者进程进入睡眠状态,这样才能避免唤醒遗失的问题。
7.6 代码:sleep 与 wakeup
xv6 的 sleep(kernel/proc.c:529)与 wakeup(kernel/proc.c:560)实现了上一个范例中给出的接口,它们的实现(再加上关于如何使用它们的规则)保证了不会出现丢失唤醒(lost wakeup)。基本的做法是:sleep 会将当前的进程标记为 SLEEPING,然后调用 sched 来释放 CPU;而 wakeup 则会找出正在某个等待通道(wait channel)上睡眠的进程,并将其标记为 RUNNABLE。sleep 和 wakeup 的调用者可以任意使用一个双方都同意的数值作为通道。xv6 通常会用与等待有关的那个内核数据结构的地址来当作这个通道。
// 原子性地释放锁并在 chan 上睡眠。
// 被唤醒后会重新取得锁。
void
sleep(void *chan, struct spinlock *lk)
{
  struct proc *p = myproc();

  // 必须先取得 p->lock,
  // 才能修改 p->state 并调用 sched。
  // 一旦我们持有 p->lock,
  // 就能保证不会错过任何 wakeup
  // (wakeup 会锁住 p->lock),
  // 因此此时释放 lk 是安全的。

  acquire(&p->lock);  //DOC: sleeplock1
  release(lk);

  // 进入睡眠。
  p->chan = chan;
  p->state = SLEEPING;

  sched();

  // 收拾善后。
  p->chan = 0;

  // 重新取得原来的锁。
  release(&p->lock);
  acquire(lk);
}

// 唤醒所有在 chan 上睡眠的进程。
// 调用时不能持有任何 p->lock。
void
wakeup(void *chan)
{
  struct proc *p;

  for(p = proc; p < &proc[NPROC]; p++) {
    if(p != myproc()){
      acquire(&p->lock);
      if(p->state == SLEEPING && p->chan == chan) {
        p->state = RUNNABLE;
      }
      release(&p->lock);
    }
  }
}
sleep 会先取得 p->lock(kernel/proc.c:540),之后才释放 lk。sleep 之所以会一直持有其中一把锁,是为了防止同时运行的 wakeup(它必须同时取得两把锁)在错误的时间介入。此时 sleep 已持有 p->lock,因此可以通过记录睡眠通道、把进程状态设为 SLEEPING,再调用 sched(kernel/proc.c:544-547)来让进程进入睡眠。稍后我们会看到,为何一定要等到进程被标记为 SLEEPING 之后,p->lock 才能被调度器释放。
之后的某个时间点,某个进程会取得条件锁、设置睡眠者所等待的条件(也就是唤醒的前提),然后调用 wakeup(chan)。这里的重点是:调用 wakeup 时必须持有这把条件锁(严格来说,只要 wakeup 紧跟在 acquire 之后就够了,也就是说可以在 release 之后调用 wakeup)。wakeup 会遍历整张进程表(kernel/proc.c:560),并对它检查的每个进程取得该进程的 p->lock:这既是因为它可能要修改该进程的状态,也是因为 p->lock 能保证 sleep 和 wakeup 不会彼此错过。如果 wakeup 发现某个进程处于 SLEEPING 状态,且它的 chan 与传进来的参数相符,就会把该进程的状态改为 RUNNABLE。接下来当调度器运行时,就会看到这个进程已经可以被运行了。
sleep 和 wakeup 的加锁规则能保证一个进程在进入睡眠时,不会错过同时发生的 wakeup。这是因为要进入睡眠的进程,从检查条件之前的某一点起,一直到它被标记为 SLEEPING 之后的某一点,始终持有条件锁、它自己的 p->lock,或者两者都持有。而调用 wakeup 的进程在它的循环中会同时持有这两把锁。因此,唤醒者要么在消费者检查条件之前就让条件成立,要么在消费者已经被标记为 SLEEPING 之后才运行 wakeup,这样就能看到睡眠中的进程并成功唤醒它(除非有其他事情先唤醒了它)。
有时会有多个进程同时在同一个通道上睡眠,例如多个进程同时从一条管道中读取;这时只需一次 wakeup 就会把它们全部唤醒。其中一个进程会先被运行,并成功取得调用 sleep 时所用的那把锁,在管道的情况下,它会读走管道中等待的数据。其他进程虽然也被唤醒,却会发现没有数据可读。从它们的角度来看,这次唤醒是“虚假的(spurious)”,它们必须再次进入睡眠。也因此,sleep 一定是包在一个会检查条件的循环中被调用的。
即使两个 sleep/wakeup 的使用者不小心选了相同的通道,也不会造成什么问题:它们可能会遇到虚假唤醒,但只要照上面所说的方式加上循环,就可以容忍这种情况。sleep/wakeup 的设计魅力之一,就在于它既轻量(不需要创建特殊的数据结构来充当睡眠通道),又提供了一层间接性(调用者不需要知道自己正在跟哪个具体的进程交互)。
7.7 代码:管道
xv6 中管道的实现是一个更复杂的例子,它用 sleep 和 wakeup 来同步生产者与消费者。我们在第 1 章中看过管道的接口:写入管道一端的字节会被拷贝进内核内部的缓冲区,之后可以从管道的另一端读出。后面的章节会探讨围绕管道的文件描述符支持,但我们现在先来看 pipewrite 与 piperead 的实现。
每个管道都用一个 struct pipe 来表示,其中包含一把锁和一个 data 缓冲区。nread 与 nwrite 这两个字段分别记录从缓冲区中读出的总字节数与写入的总字节数。这个缓冲区是环形的:写入 buf[PIPESIZE-1] 之后,下一个字节会被写入 buf[0]。但计数器 nread 和 nwrite 并不会这样回绕。
这种设计让实现可以简单地区分缓冲区已满(nwrite == nread + PIPESIZE)与缓冲区为空(nwrite == nread)的状态,但也意味着对缓冲区的访问必须使用 buf[nread % PIPESIZE],不能直接用 buf[nread](对 nwrite 也是如此)。
假设此时有两个不同的 CPU 分别同时调用 piperead 与 pipewrite。pipewrite(kernel/pipe.c:77)会先取得管道的锁,这把锁保护的是计数器、数据与相关的不变量。此时 piperead(kernel/pipe.c:106)也会尝试取得这把锁,但无法取得,因此它会卡在 acquire(kernel/spinlock.c:22)中自旋等待锁释放。
int
pipewrite(struct pipe *pi, uint64 addr, int n)
{
  int i = 0;
  struct proc *pr = myproc();

  acquire(&pi->lock);
  while(i < n){
    if(pi->readopen == 0 || pr->killed){
      release(&pi->lock);
      return -1;
    }
    if(pi->nwrite == pi->nread + PIPESIZE){ //DOC: pipewrite-full
      wakeup(&pi->nread);
      sleep(&pi->nwrite, &pi->lock);
    } else {
      char ch;
      if(copyin(pr->pagetable, &ch, addr + i, 1) == -1)
        break;
      pi->data[pi->nwrite++ % PIPESIZE] = ch;
      i++;
    }
  }
  wakeup(&pi->nread);
  release(&pi->lock);

  return i;
}

int
piperead(struct pipe *pi, uint64 addr, int n)
{
  int i;
  struct proc *pr = myproc();
  char ch;

  acquire(&pi->lock);
  while(pi->nread == pi->nwrite && pi->writeopen){  //DOC: pipe-empty
    if(pr->killed){
      release(&pi->lock);
      return -1;
    }
    sleep(&pi->nread, &pi->lock); //DOC: piperead-sleep
  }
  for(i = 0; i < n; i++){  //DOC: piperead-copy
    if(pi->nread == pi->nwrite)
      break;
    ch = pi->data[pi->nread++ % PIPESIZE];
    if(copyout(pr->pagetable, addr + i, &ch, 1) == -1)
      break;
  }
  wakeup(&pi->nwrite);  //DOC: piperead-wakeup
  release(&pi->lock);
  return i;
}
当 piperead 还在等待时,pipewrite 会在循环中把 addr[0..n-1] 的数据逐一写进管道(kernel/pipe.c:95)。在这个过程中,可能会遇到缓冲区被填满的情况(kernel/pipe.c:88),此时 pipewrite 会调用 wakeup 去通知任何正在等待的读者,表示缓冲区里有数据可读,然后自己在 &pi->nwrite 上调用 sleep,等待某个读者从缓冲区中拿走一些字节。这个 sleep 在让 pipewrite 所在的进程进入睡眠状态的同时,也释放了 pi->lock。
此时 piperead 取得了管道的锁并进入临界区:它发现 pi->nread != pi->nwrite(kernel/pipe.c:113)(这代表之前 pipewrite 是因为 pi->nwrite == pi->nread + PIPESIZE 才进入 sleep 的,见 kernel/pipe.c:88),所以接着进入 for 循环,从管道中把数据拷贝出去(kernel/pipe.c:120),并根据拷贝的字节数增加 nread。此时这些空出来的字节就又可供写入了,因此 piperead 会调用 wakeup(kernel/pipe.c:127)唤醒可能在等待的写者。wakeup 会找到那个在 &pi->nwrite 上睡眠的进程,也就是之前运行 pipewrite、因为缓冲区满了而进入睡眠的那个进程,并把该进程标记为 RUNNABLE。
管道的代码为读者和写者使用了不同的睡眠通道(分别是 pi->nread 与 pi->nwrite);这么做可能会让系统在有大量读者和写者同时等待同一条管道的情况下更有效率。管道的睡眠都写在一个会检查条件的循环中;如果有多个读者或写者,除第一个醒来的进程之外,其他人都会因为条件还不成立而再次进入睡眠。
7.8 代码:wait、exit 与 kill
sleep 和 wakeup 可以用在许多种类的等待情境中。一个有趣的例子是在第 1 章中介绍过的:子进程的 exit 和父进程的 wait 之间的交互。在子进程终止时,父进程可能已经因 wait 而处于睡眠中,或是正在运行其他事情;如果是后者,那么即使距离 exit 被调用已经过去了一段时间,之后调用 wait 时也必须能够观察到子进程的死亡。xv6 记录子进程死亡(直到 wait 观察到它)的做法是:让 exit 把调用者置于 ZOMBIE 状态,子进程会保持在该状态,直到父进程的 wait 察觉到它,接着把子进程的状态改成 UNUSED,拷贝它的退出状态,并把子进程的 PID 返回给父进程。如果父进程在子进程之前结束,那么父进程会把子进程移交给 init 进程,而 init 会永久地调用 wait;因此每个子进程都会有一个负责为它清理的父进程。实现上的挑战在于如何避免父进程和子进程同时调用 wait 或 exit、或两个进程同时调用 exit 时产生竞态条件或死锁。
// 终止当前进程。不会返回。
// 已退出的进程会保持在 zombie 状态,
// 直到它的父进程调用 wait()。
void
exit(int status)
{
  struct proc *p = myproc();

  if(p == initproc)
    panic("init exiting");

  // 关闭所有打开的文件。
  for(int fd = 0; fd < NOFILE; fd++){
    if(p->ofile[fd]){
      struct file *f = p->ofile[fd];
      fileclose(f);
      p->ofile[fd] = 0;
    }
  }

  begin_op();
  iput(p->cwd);
  end_op();
  p->cwd = 0;

  acquire(&wait_lock);

  // 把所有子进程交给 init。
  reparent(p);

  // 父进程可能正在 wait() 中睡眠。
  wakeup(p->parent);

  acquire(&p->lock);

  p->xstate = status;
  p->state = ZOMBIE;

  release(&wait_lock);

  // 跳进调度器,不再返回。
  sched();
  panic("zombie exit");
}
wait 会先取得 wait_lock(kernel/proc.c:384),这把锁扮演着条件锁的角色,用来确保父进程不会错过正在退出的子进程发出的 wakeup。接着 wait 会扫描整张进程表,如果找到一个状态为 ZOMBIE 的子进程,它会释放该子进程的资源和它的 proc 结构,并把子进程的退出状态拷贝到传给 wait 的地址中(如果该地址不是 0),然后返回该子进程的 PID。
如果 wait 找到一些子进程,但都还没有 exit,它就会调用 sleep 来等待其中任何一个退出(kernel/proc.c:426),然后再次扫描。wait 经常同时持有两把锁:wait_lock 和某个子进程的 np->lock。为了避免死锁,持锁的顺序必须是先取 wait_lock 再取 np->lock。
// 等待某个子进程退出并返回它的 pid。
// 如果这个进程没有子进程,返回 -1。
int
wait(uint64 addr)
{
  struct proc *np;
  int havekids, pid;
  struct proc *p = myproc();

  acquire(&wait_lock);

  for(;;){
    // 扫描进程表,寻找已退出的子进程。
    havekids = 0;
    for(np = proc; np < &proc[NPROC]; np++){
      if(np->parent == p){
        // 确认子进程没有仍停留在 exit() 或 swtch() 中。
        acquire(&np->lock);

        havekids = 1;
        if(np->state == ZOMBIE){
          // 找到一个。
          pid = np->pid;
          if(addr != 0 && copyout(p->pagetable, addr, (char *)&np->xstate,
                                  sizeof(np->xstate)) < 0) {
            release(&np->lock);
            release(&wait_lock);
            return -1;
          }
          freeproc(np);
          release(&np->lock);
          release(&wait_lock);
          return pid;
        }
        release(&np->lock);
      }
    }

    // 如果我们没有任何子进程,就没有等待的必要。
    if(!havekids || p->killed){
      release(&wait_lock);
      return -1;
    }

    // 等待某个子进程退出。
    sleep(p, &wait_lock);  //DOC: wait-sleep
  }
}
exit(kernel/proc.c:340)会记录退出状态、释放部分资源、调用 reparent 把自己的子进程移交给 init 进程、唤醒可能正在 wait 中的父进程、把自己标记为僵尸,并永久让出 CPU。exit 在这一系列过程中会同时持有 wait_lock 和 p->lock。持有 wait_lock 是因为它是 wakeup(p->parent) 的条件锁,这可以防止正在 wait 中的父进程丢失这次唤醒。它也必须持有 p->lock,以避免在子进程最终调用 swtch 之前,父进程在 wait 中看到子进程处于 ZOMBIE 状态。exit 的加锁顺序与 wait 相同,以避免死锁。
exit 在把自己的状态设为 ZOMBIE 之前就唤醒父进程,看起来好像不太正确,但这其实是安全的:虽然 wakeup 可能会让父进程被调度运行,但 wait 中的循环在该子进程的 p->lock 被调度器释放之前无法检查这个子进程,因此 wait 不会太早看到这个正在退出的进程,那时 exit 早已把状态设为 ZOMBIE(kernel/proc.c:372)。
exit 允许一个进程终止自己,而 kill(kernel/proc.c:579)则允许某个进程请求终止另一个进程。让 kill 直接销毁目标进程会太过复杂,因为该目标可能正在另一个 CPU 上运行,甚至可能正处于对内核数据结构进行敏感更新的序列中间。因此 kill 所做的事情非常简单:它只会设置目标进程的 p->killed,如果该进程正在睡眠,也会把它唤醒。最终这个被 kill 的进程会进入或离开内核,而在那个时间点,usertrap 中的代码会检查 p->killed 是否被设置,如果有被设置就调用 exit。如果该进程当时正运行在用户空间,它很快就会因为系统调用或时钟(或其他设备)的中断而进入内核。
如果目标进程此时正在 sleep,那么 kill 对 wakeup 的调用就会让它从 sleep 返回。这其实是有潜在风险的,因为它原本等待的条件可能仍然不成立。不过在 xv6 里,所有对 sleep 的调用都包在一个 while 循环中,sleep 返回之后会重新检查条件。有些 sleep 的调用还会在循环中检查 p->killed,如果发现它被设置了,就会放弃当前的活动。这只有在放弃当前操作是合理的情况下才会这样做,例如管道的读写代码(kernel/pipe.c:84)就会在 killed 标志被设置时直接返回;之后代码最终会回到陷入处理程序,那里会再次检查 p->killed 并执行 exit。
有些 xv6 中的睡眠循环并不会检查 p->killed,因为这些代码正处于一个应当保持原子性的多步系统调用之中。virtio 驱动(kernel/virtio_disk.c:273)就是一个例子:它不会检查 p->killed,因为单个磁盘操作可能是一组写入中的其中一部分,而这些写入全部完成后,文件系统的状态才会是正确的。一个在等待磁盘 I/O 的期间被 kill 的进程不会退出,它会先完成当前的系统调用,等回到 usertrap 看到 killed 标志时才会结束。
7.9 进程加锁
每个进程所对应的锁(p->lock)是 xv6 中最复杂的锁。要理解 p->lock,一个简单的方式是:只要读取或写入下列 struct proc 字段中的任何一个,就必须持有这把锁:p->state、p->chan、p->killed、p->xstate,以及 p->pid。这些字段可能会被其他进程,或者其他核心上的调度器线程访问,因此需要用锁来保护。
然而,p->lock 的大多数用途其实是在保护 xv6 中进程数据结构与算法的更高层次面向。以下列出 p->lock 所负责的全部事项:
- 它与
p->state配合,可以防止在分配proc[]中的新进程槽位(slot)时发生竞态条件proc[]是全系统的进程表,而创建新进程时需要找一个UNUSED的槽位。若没有锁,可能两个 CPU 同时选中一个槽位。持有p->lock可让检查state == UNUSED和后续设置变成原子操作
- 在进程被创建或销毁的过程中,它能让该进程对外“不可见”
- 一个进程尚未完成初始化,或还没清除完内存之前,不应被其他人查找或操作。持有
p->lock可避免其他人看到尚未准备好或已经部分销毁的进程状态
- 一个进程尚未完成初始化,或还没清除完内存之前,不应被其他人查找或操作。持有
- 它可以防止父进程的
wait回收一个已经把状态设为ZOMBIE但还没有让出 CPU 的进程 - 它可以防止另一个核心的调度器在一个进程把状态设成
RUNNABLE之后、但还没完成swtch之前,就决定要运行它- 从
RUNNING切换出去时状态会被改为RUNNABLE,但此时还没完成上下文切换。如果其他调度器此时看到RUNNABLE而选中它,会产生不一致
- 从
- 它能保证只有一个核心的调度器决定要运行某个
RUNNABLE的进程- 防止两个调度器同时选中同一个进程
- 它防止时钟中断在一个进程正处于
swtch之中时又让它让出 CPU- 如果在切换上下文的过程中又被中断,可能会造成进程被不当地抢占。这一条说明
p->lock是让swtch对时钟中断保持原子性的手段之一
- 如果在切换上下文的过程中又被中断,可能会造成进程被不当地抢占。这一条说明
- 它与条件锁配合,可以防止
wakeup漏掉一个正在调用sleep、但还没完成让出 CPU 的进程 - 它防止
kill在检查p->pid之后、设置p->killed之前,目标进程就已经退出并可能被重新分配- PID 是唯一标识进程的 ID,但
proc[]中的槽位是会被重用的。如果在kill检查pid之后、设置killed之前,该槽位被别的进程占用了,就可能杀错进程
- PID 是唯一标识进程的 ID,但
- 它让
kill对p->state的检查与写入成为一个原子操作- 不只是
pid,对state的操作也要是安全的。否则kill可能对不该被终止的进程状态进行操作
- 不只是
p->parent 字段则由全局的 wait_lock 保护,而不是由 p->lock 保护。只有进程的父进程会修改 p->parent,不过这个字段也会被这个进程自己以及其他寻找自己子进程的进程所读取。wait_lock 的用途是当 wait 调用进入睡眠、等待某个子进程退出时,充当条件锁。一个正在退出的子进程会持有 wait_lock 或 p->lock,直到它把自己的状态设为 ZOMBIE、唤醒父进程,并让出 CPU 为止。
wait_lock 也会串行化父进程与子进程同时调用 exit 的情况,这样 init 进程(它继承了该子进程)就能保证会从 wait 中被唤醒。wait_lock 是一把全局的锁,而不是每个父进程都有一把,因为在进程拿到它之前,它还不知道谁是自己的父进程。
7.10 现实世界
xv6 的调度器采用一种简单的调度策略:轮流运行每个进程,这种策略被称为轮转(round robin)。而实际的操作系统会实现更复杂的策略,例如允许进程拥有优先级。这样一来,调度器会更倾向于选择可运行的高优先级进程,而不是低优先级进程。不过这类策略通常很快就会变得复杂,因为操作系统往往同时还想达成其他彼此竞争的目标,例如公平性与高吞吐量。
此外,复杂的调度策略还可能导致一些非预期的交互问题,例如优先级反转(priority inversion)与护航效应(convoys)。优先级反转会发生在低优先级与高优先级的进程同时使用某把锁、而这把锁被低优先级的进程持有时,就会阻止高优先级的进程前进。当许多高优先级的进程在等待一个持有了共享锁的低优先级进程时,就可能形成长串的等待队列(convoy);一旦这样的 convoy 形成,可能会持续很长一段时间,导致性能下降。为了避免这些问题,更精密的调度器必须加入额外的机制。
sleep 与 wakeup 是一种简单而有效的同步方法,但还有很多其他同步方式。这些方法的首要挑战都是避免本章开头所提到的“丢失唤醒”问题。早期 Unix 内核的 sleep 做法只是简单地关闭中断,因为 Unix 运行在单 CPU 的系统上,这样已经足够了。但因为 xv6 运行在多处理器系统上,它给 sleep 加入了一把显式的锁。
FreeBSD 的 msleep 采取了相同的做法。Plan 9 的 sleep 则是使用一个回调函数,在进入睡眠之前、持有调度锁时运行该函数,作为对睡眠条件的最后一次检查,以避免丢失唤醒。Linux 内核的 sleep 使用一个显式的进程队列,称为等待队列(wait queue),来取代等待通道;这个队列自身有其内部的锁。
在 wakeup 中扫描整个进程集合是一种低效率的做法。更好的做法是把 sleep 和 wakeup 中的 chan 换成一种数据结构,这个数据结构能保存在该结构上睡眠的进程列表,例如 Linux 使用的等待队列。Plan 9 的 sleep 与 wakeup 将这个结构称为会合点(rendezvous point)或 Rendez。许多线程库把同样的东西称为条件变量(condition variable);在这种情况下,sleep 与 wakeup 的操作分别被称为 wait 与 signal。所有这些机制的核心思路是一样的:睡眠的条件会受到某种锁的保护,并且这把锁会在睡眠的同时被原子性地释放。
wakeup 的实现会唤醒所有在特定通道上等待的进程,而在某些情况下,可能有很多进程都在等同一个通道。操作系统会将这些进程全部排入调度,然后它们会竞争着去检查睡眠条件。行为如此的进程有时被称为“雷群效应(thundering herd)”,应该尽量避免这种情况发生。大多数的条件变量提供两个与 wakeup 相关的操作:signal(唤醒一个进程)以及 broadcast(唤醒所有等待中的进程)。
信号量(semaphore)也经常被用来做同步。它的计数通常代表的像是管道缓冲区中可用的字节数,或是某个进程拥有的僵尸子进程数量。把这个计数值纳入抽象的一部分,可以避免“丢失唤醒”的问题:因为已经发生的唤醒次数是被明确计数的。此外,这个计数也能避免虚假唤醒(spurious wakeup)与雷群效应的问题。
在 xv6 中终止进程并清理其资源会引入相当多的复杂性。在大多数操作系统中,这件事甚至更加复杂,因为被终止的进程可能在内核里处于很深的睡眠状态,而要展开(unwind)它的调用栈时必须非常小心,因为调用栈上的每个函数都可能需要做一些清理工作。有些编程语言提供异常处理机制来协助这类清理,但 C 语言没有。
此外,还有其他事件可能会导致一个正在睡眠的进程被唤醒,即使它等待的事件尚未发生。例如,在 Unix 中,如果一个进程处于睡眠状态,其他进程可以向它发送信号(signal)。在这种情况下,该进程会从中断的系统调用返回,返回值为 -1,同时将错误码设为 EINTR。应用程序可以根据这些值来决定后续处理方式。而 xv6 不支持信号,因此不会遇到这类复杂性。
xv6 中对 kill 的支持并不完全令人满意:有些睡眠循环大概应该检查 p->killed 却没有检查。另一个相关的问题是,即便某些睡眠循环会检查 p->killed,仍然会遇到 sleep 与 kill 之间的竞态条件:kill 可能会在受害者的循环检查完 p->killed、但尚未调用 sleep 之前设下 p->killed 并试图唤醒受害者。如果发生这种情况,受害者将无法察觉 p->killed,直到它所等待的条件真的成立。这可能是很久以后,甚至永远不会发生(例如如果受害者正在等待来自控制台的输入,而用户没有键入任何内容)。
真正的操作系统会使用显式的空闲链表(free list)来在常数时间内找到空闲的 proc 结构,而不是像 xv6 那样在 allocproc 里用线性搜索的方式;xv6 采用线性扫描是为了简化设计。
7.11 练习
-
sleep必须检查lk != &p->lock才能避免死锁。假设把这个特殊情况去掉,也就是把:c if(lk != &p->lock){ acquire(&p->lock); release(lk); }替换成:
c
release(lk);
acquire(&p->lock);
这样做会使
sleep出错。为什么? -
在不使用
sleep与wakeup的前提下,在 xv6 中实现信号量(可以使用自旋锁)。把 xv6 中使用sleep与wakeup的地方都改用信号量取代。并评估这样做的结果。 - 修正前面提到的
kill与sleep之间的竞态条件,使得当kill发生在受害者的睡眠循环已经检查过p->killed但尚未调用sleep之间时,受害者仍会放弃当前的系统调用。 - 设计一个方案,让所有睡眠循环都会检查
p->killed。例如,让在 virtio 驱动中的进程被其他进程kill时,能够快速跳出 while 循环。 - 修改 xv6,使从一个进程的内核线程切换到另一个时,只需要一次上下文切换,而不是通过调度器线程切换。让出 CPU 的线程需要自行选出下一个要运行的线程并调用
swtch。挑战包括避免多个核心同时运行同一个线程、把加锁做正确,以及避免死锁。 - 修改 xv6 的调度器,当没有任何进程可运行时,使用 RISC-V 的
WFI(wait for interrupt,等待中断)指令。尝试确保只要还有进程处于可运行状态,就不会有核心还在运行WFI。
第 8 章 文件系统
文件系统的目的是组织与保存数据。文件系统通常也会支持用户与应用程序之间的数据共享,并具备数据的持久性,也就是在重新启动后数据仍然可用。xv6 的文件系统提供类 Unix 的文件、目录与路径名(详见第 1 章),并通过 virtio 硬盘来保存数据以达成持久性。这个文件系统需要面对数个挑战:
- 文件系统需要在硬盘上创建数据结构,来表示具名目录与文件所组成的树状结构,记录每个文件内容所使用的块的位置,并追踪硬盘中哪些区域尚未被使用。
- 文件系统必须支持崩溃恢复(crash recovery)。也就是说,如果系统在某次操作中途崩溃(例如电源故障),重新启动后文件系统仍必须能够正常运作。崩溃的风险在于,它可能会中断一连串更新操作,使硬盘上的数据结构处于不一致的状态(例如某个块既被某个文件使用,又被标记为空闲)。
- 不同的进程可能会同时操作文件系统,因此文件系统的代码必须协调彼此之间的动作,以维护数据的一致性与不变式。
- 访问硬盘的速度远比访问内存慢好几个数量级,因此文件系统必须在内存中维护一个常用块的缓存。
本章余下部分将说明 xv6 是如何应对这些挑战的。
8.1 概述
xv6 的文件系统实现被划分为七个层次,如图 8.1 所示。最底层是磁盘层(disk layer),负责对 virtio 硬盘进行块的读写。缓冲区缓存层(buffer cache layer)会缓存磁盘块并协调对它们的访问,确保同一时刻只有一个内核进程可以修改某个特定块中所存放的数据。日志层(logging layer)允许更高层级的程序把对多个块的更新包装成一个事务(transaction),并保证在系统崩溃的情况下这些更新能够被原子地完成(也就是要么全部更新,要么全部不更新)。
inode 层(inode layer)提供单个文件的表示方式,每个文件由一个 inode 表示,具有唯一的 i-number,以及一些保存文件内容的块。目录层(directory layer)把每个目录实现成一种特殊的 inode,其内容是一串目录项(directory entry),每个目录项包含一个文件名与对应的 i-number。路径名层(pathname layer)提供层次式路径名,例如 /usr/rtm/xv6/fs.c,并通过递归查找来解析这些路径名。文件描述符层(file descriptor layer)则用文件系统的接口把许多 Unix 资源(例如管道、设备、文件等)抽象成文件,让应用程序程序员的工作变得更简单。
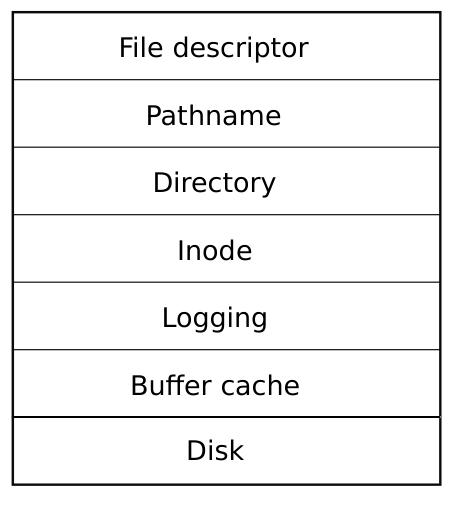
硬盘硬件传统上会把硬盘内的数据呈现为一个个 512 字节块(也称为扇区)的编号序列:扇区 0 是最前面的 512 字节,扇区 1 是接下来的 512 字节,以此类推。操作系统在文件系统中使用的块大小可以与硬盘的扇区大小不同,但通常是扇区大小的倍数。xv6 会把读入内存的块的副本保存在类型为 struct buf 的对象中(kernel/buf.h:1)。这些结构中存放的数据有时与硬盘上的实际数据不同步:例如数据可能还没从硬盘中读取完成(硬盘正在处理,但尚未返回该扇区的内容),或者数据已被软件修改但尚未写回硬盘。
文件系统必须规划好要把 inode 与内容块存放在硬盘上的哪些位置。为此,xv6 把整个硬盘划分成几个区段,如图 8.2 所示。文件系统不使用块 0(它保存引导扇区)。块 1 称为超级块(superblock),其中包含关于文件系统的元数据(以块为单位的文件系统大小、数据块的数量、inode 的数量,以及日志中所用的块数)。从块 2 开始的区段用来存放日志。日志之后是 inode 区段,每个块内会存放多个 inode。再往后是位图(bitmap)块,用来追踪哪些数据块已被使用。剩下的块是数据块;每个数据块要么在位图块中被标记为空闲,要么保存文件或目录的内容。超级块由一个名为 mkfs 的独立程序填写,它会构建一个初始的文件系统。
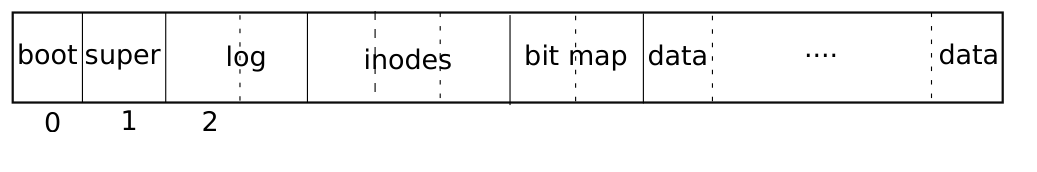
本章余下部分将依次介绍每个层次,从缓冲区缓存开始。请特别注意那些设计良好的底层抽象是如何让更高层的设计变得更简洁的。
8.2 缓冲区缓存层
缓冲区缓存有两个主要任务:一是同步对磁盘块的访问,确保内存中对每个块只有一个副本,并且同一时刻只有一个内核线程使用该副本;二是缓存常用块,使它们不必从缓慢的硬盘中重新读取。相关代码位于 bio.c。
缓冲区缓存对外提供的主要接口包括 bread 与 bwrite;前者取得一个 buf,也就是某个块在内存中的副本,这份数据可以被读取或修改,后者则把修改过的缓冲区写回硬盘上对应的块。内核线程使用完一个缓冲区后,必须调用 brelse 来释放它。缓冲区缓存为每个缓冲区使用一把睡眠锁(sleep-lock),以确保同一时刻只有一个线程能使用某个缓冲区(也就是某个磁盘块);bread 返回一个已上锁的缓冲区,而 brelse 会释放该锁。
再回到缓冲区缓存。它只有固定数量的缓冲区可用来保存磁盘块,这意味着如果文件系统请求一个当前不在缓存中的块,缓冲区缓存就必须回收一个当前保存着其他块的缓冲区。它会回收最近最少使用(least recently used,LRU)的那个缓冲区来存放新的块。这基于一个假设:最近最少使用的缓冲区很可能在短期内也不会再被使用。
8.3 代码:缓冲区缓存
缓冲区缓存是由多个缓冲区组成的双向链表。main 会调用 binit(kernel/main.c:27),用静态数组 buf 中的 NBUF 个缓冲区来初始化这个链表(kernel/bio.c:43-52)。此后所有对缓冲区缓存的访问都通过 bcache.head 指向的链表进行,而不再直接使用 buf 数组。
struct {
  struct spinlock lock;
  struct buf buf[NBUF];

  // 所有缓冲区通过 prev/next 连成链表。
  // 按缓冲区最近被使用的时间排序。
  // head.next 是最新的,head.prev 是最旧的。
  struct buf head;
} bcache;

void
binit(void)
{
  struct buf *b;

  initlock(&bcache.lock, "bcache");

  // 创建缓冲区链表
  bcache.head.prev = &bcache.head;
  bcache.head.next = &bcache.head;
  for(b = bcache.buf; b < bcache.buf+NBUF; b++){
    b->next = bcache.head.next;
    b->prev = &bcache.head;
    initsleeplock(&b->lock, "buffer");
    bcache.head.next->prev = b;
    bcache.head.next = b;
  }
}
每个缓冲区都有两个与其状态有关的字段。valid 字段表示这个缓冲区当前含有某个块的副本。disk 字段表示该缓冲区的内容已交由硬盘处理,也就是硬盘可能会修改它(例如把数据从硬盘读入 data 数组中)。
struct buf {
  int valid;   // 数据是否已从硬盘读入?
  int disk;    // 硬盘是否“拥有”这个缓冲区?
  uint dev;
  uint blockno;
  struct sleeplock lock;
  uint refcnt;
  struct buf *prev; // LRU 缓存链表
  struct buf *next;
  uchar data[BSIZE];
};
bread(kernel/bio.c:93)会调用 bget 来取得与给定扇区对应的缓冲区(kernel/bio.c:97)。如果这个缓冲区需要从硬盘读取数据,bread 会调用 virtio_disk_rw 完成读取,然后才返回这个缓冲区。
// 返回一个已上锁的 buf,其中含有指定块的内容。
struct buf*
bread(uint dev, uint blockno)
{
  struct buf *b;

  b = bget(dev, blockno);
  if(!b->valid) {
    virtio_disk_rw(b, 0);
    b->valid = 1;
  }
  return b;
}
bget(kernel/bio.c:59)会扫描缓冲区链表,寻找一个拥有给定设备号与扇区号的缓冲区(kernel/bio.c:65-73)。若找到了这样的缓冲区,bget 就会为它取得睡眠锁,然后返回这个已上锁的缓冲区。
如果该扇区没有对应的缓存缓冲区,bget 就必须新建一个,这可能会复用一个当前保存着其他扇区的缓冲区。接着它会再次扫描缓冲区链表,寻找一个未被使用的缓冲区(b->refcnt = 0);只要符合这个条件就可以使用。bget 随后会修改这个缓冲区的元数据(metadata),把设备号与扇区号改成新的值,并为它上锁。要注意,b->valid = 0 这行会强制让 bread 之后重新从硬盘读取数据,避免错误地使用这个缓冲区此前的内容。
每个磁盘扇区最多只能有一个对应的缓存缓冲区,这一点非常重要,因为这样才能保证读取端能看到写入端的更新结果,而且文件系统也依靠对缓冲区上锁来实现同步。bget 为了确保这个不变式,会在从第一次循环检查该块是否已被缓存,一直到第二次循环声明该块现在已被缓存(即设置 dev、blockno 与 refcnt)的整个过程中,持续持有 bcache.lock。这样就把“检查某个块是否存在”与“指定一个缓冲区来存放该块”这两个步骤形成了一个原子操作。
// 在缓冲区缓存中查找设备 dev 上的块。
// 若未找到,分配一个缓冲区。
// 两种情况下都返回已上锁的缓冲区。
static struct buf*
bget(uint dev, uint blockno)
{
  struct buf *b;

  acquire(&bcache.lock);

  // 该块是否已被缓存?
  for(b = bcache.head.next; b != &bcache.head; b = b->next){
    if(b->dev == dev && b->blockno == blockno){
      b->refcnt++;
      release(&bcache.lock);
      acquiresleep(&b->lock);
      return b;
    }
  }

  // 未缓存。
  // 回收最近最少使用(LRU)的空闲缓冲区。
  for(b = bcache.head.prev; b != &bcache.head; b = b->prev){
    if(b->refcnt == 0) {
      b->dev = dev;
      b->blockno = blockno;
      b->valid = 0;
      b->refcnt = 1;
      release(&bcache.lock);
      acquiresleep(&b->lock);
      return b;
    }
  }
  panic("bget: no buffers");
}
bget 在离开 bcache.lock 的临界区之后再取得缓冲区的睡眠锁是安全的,因为只要 b->refcnt 不为 0,就能防止该缓冲区被复用于其他磁盘块。睡眠锁用来保护对这个块内容的读写操作,而 bcache.lock 则用来保护“哪些块已被缓存”的相关信息。
如果所有缓冲区都在忙碌,说明有太多个进程同时在执行文件系统调用;这时 bget 会直接 panic。比较温和的处理方式是让该进程睡眠,直到有缓冲区变为可用,但这样就会有死锁的可能性。
一旦 bread 从硬盘读取数据(如有需要)并把缓冲区返回给调用者,调用者就独占这个缓冲区,可以任意读取或写入其中的数据字节。如果调用者修改了缓冲区,就必须先调用 bwrite 把变更写回硬盘,然后才能释放缓冲区。bwrite(kernel/bio.c:107)会调用 virtio_disk_rw 与硬盘硬件沟通。
// 把 b 的内容写入硬盘。b 必须已上锁。
void
bwrite(struct buf *b)
{
  if(!holdingsleep(&b->lock))
    panic("bwrite");
  virtio_disk_rw(b, 1);
}
当调用者使用完一个缓冲区时,必须调用 brelse 来释放它。(brelse 这个名称是 b-release 的缩写,虽然晦涩,但值得学习:它源自 Unix,并在 BSD、Linux、Solaris 等系统中沿用至今。)brelse(kernel/bio.c:117)会释放这个缓冲区的睡眠锁,并把它移动到链表的表头(kernel/bio.c:128-133)。这样移动会让整个链表按缓冲区最近被使用(也就是最近被释放)的时间排序:链表中的第一个缓冲区是最近才使用过的,最后一个是最近最少被使用的。
// 释放一个已上锁的缓冲区。
// 移动到“最近最少使用”链表的表头。
void
brelse(struct buf *b)
{
  if(!holdingsleep(&b->lock))
    panic("brelse");

  releasesleep(&b->lock);

  acquire(&bcache.lock);
  b->refcnt--;
  if (b->refcnt == 0) {
    // 没有人在等待它。
    b->next->prev = b->prev;
    b->prev->next = b->next;
    b->next = bcache.head.next;
    b->prev = &bcache.head;
    bcache.head.next->prev = b;
    bcache.head.next = b;
  }

  release(&bcache.lock);
}
bget 中的两段循环正利用了这种排序:在寻找既有缓冲区的那一段,最坏情况下要扫过整个链表,但如果引用局部性(locality of reference)良好,从 bcache.head 开始沿着 next 指针往后找就能缩短搜索时间。而在挑选可复用缓冲区的那一段,则通过沿 prev 指针反向扫描来选出最近最少使用的缓冲区。
8.4 日志层
在文件系统设计中,崩溃恢复是一个非常有趣的问题。这个问题源于许多文件系统操作要包含多次对硬盘的写入:如果在这些写入只完成一部分时系统发生崩溃,硬盘上的文件系统就可能处于不一致的状态。例如,假设崩溃发生在执行文件截断(把文件长度设为 0 并释放其内容块)的过程中。根据硬盘写入顺序的不同,崩溃后可能出现以下两种情况之一:要么留下一个仍然引用着某个实际已被标记为空闲的内容块的 inode,要么留下一个已被分配但没有任何 inode 引用的内容块。
第二种情况相对无害;但如果一个 inode 仍然指向一个已被释放的块,在重新启动后很可能引发严重问题。因为重新启动后,内核可能会把该块分配给另一个文件,于是我们就有了两个不同的文件意外地指向同一个块。如果 xv6 支持多个用户,这种状况甚至可能变成一个安全漏洞,因为原文件的拥有者此时可以读写属于另一个用户的新文件中的数据块。
xv6 用一种简化的日志机制来解决文件系统操作期间发生崩溃的问题。xv6 的系统调用并不会直接修改硬盘上的文件系统数据结构,而是先把所有它想要执行的硬盘写入的描述记录到硬盘上的日志区段。等到所有写入动作都被记入日志之后,系统调用再向硬盘写入一条特殊的提交(commit)记录,表示日志中包含了一笔完整的操作。到了这一步,系统调用才把这些写入复制到硬盘上的文件系统数据结构中。这些写入完成之后,系统调用会清除硬盘上的日志。
如果系统崩溃并重新启动,文件系统代码会在运行任何进程之前先按以下方式从崩溃中恢复。若日志被标记为包含一笔完整的操作,恢复程序就把这笔操作所对应的写入复制到它们在硬盘上应有的位置。反之,如果日志没有被标记为包含完整的操作,恢复程序就会忽略这份日志。最后,恢复程序会清除硬盘上的日志。
xv6 的日志为什么能解决文件系统操作期间发生崩溃的问题?如果崩溃发生在操作提交之前,那么硬盘上的日志不会被标记为完整,恢复程序会忽略它,此时硬盘的状态就如同这笔操作根本还没开始。如果崩溃发生在操作提交之后,恢复程序会重放这笔操作的所有写入,即使这些写入在崩溃前已经部分套用到其数据结构上(重放可能会重复它们)。无论哪种情况,日志都让文件系统的操作相对于崩溃具有原子性:恢复之后,要么这笔操作的所有写入都在硬盘上,要么一个都没有。
8.5 日志设计
日志存放在硬盘上一个已知的固定位置,该位置由超级块指定。日志由一个头部块(header block)以及其后一连串更新后的块的副本(称为“被记录的块”)组成。头部块中有一个扇区号数组,对应每个被记录的块各自的扇区号,还有一个日志块数量的计数值。
// 头部块的内容,既用于硬盘上的头部块,
// 也用于在内存中记录提交前被记录的块号。
struct logheader {
  int n;
  int block[LOGSIZE];
};

struct log {
  struct spinlock lock;
  int start;
  int size;
  int outstanding; // 有多少个文件系统系统调用正在执行。
  int committing;  // 正处于 commit() 中,请等待。
  int dev;
  struct logheader lh;
};
struct log log;
硬盘上头部块中的计数值要么为 0,表示日志中不存在任何事务;要么为非零值,表示日志中包含一笔完整的、已提交的事务,其中指定了被记录块的数量。xv6 在事务提交时才写入这个头部块(而不是提前),并在把被记录的块复制到文件系统之后把计数值清 0。因此,如果事务执行到一半时崩溃,日志头部块中的计数值就会是 0;如果在提交之后才崩溃,计数值则为非零值。
每个系统调用的代码都会标示出写入序列的起点与终点,在这之间的写入对崩溃来说必须是原子的。为了允许不同进程同时执行文件系统操作,日志系统可以把多个系统调用的写入累积到同一笔事务中。因此,单次提交可能包含多个完整系统调用的写入。为了避免把某个系统调用的写入拆分到不同的事务中,日志系统只有在没有任何文件系统系统调用正在执行时才会进行提交。
把多笔事务一起提交的概念称为成组提交(group commit)。成组提交能减少硬盘操作的次数,因为它可以把一次提交的固定成本分摊到多笔操作上。此外,成组提交也会让硬盘系统一次接收到较多笔写入,有机会让硬盘在一次旋转期间就完成所有写入。虽然 xv6 所用的 virtio 驱动并不支持这种批处理,但 xv6 的文件系统设计仍然允许这么做。
xv6 在硬盘上预留了一块固定大小的空间用来存放日志。一笔事务中由各个系统调用写入的块数必须能够塞进这块日志空间。这会产生两个后果:
- 不能让任何一个系统调用写入比日志空间还多的块
- 这对大多数系统调用来说不是问题,但有两个系统调用可能会写入大量块:
write与unlink- 对一个大型文件的
write操作,可能需要写入很多个数据块、很多个位图块,甚至还包含一个 inode 块 unlink一个大型文件也可能会涉及多个位图块与 inode 的写入
- 对一个大型文件的
- xv6 的
write系统调用会把大型写入拆分成多个较小的操作,每次都能够塞进日志;而unlink则没有造成实际问题,因为 xv6 的文件系统在实践中只会用到一个位图块
- 这对大多数系统调用来说不是问题,但有两个系统调用可能会写入大量块:
- 由于日志空间有限,在日志系统确认一个系统调用的所有写入能够完全塞进剩余的日志空间之前,不能允许该系统调用开始执行。
8.6 代码:日志
一笔系统调用中使用日志系统的典型方式如下所示:
begin_op();
...
bp = bread(...);
bp->data[...] = ...;
log_write(bp);
...
end_op();
begin_op(kernel/log.c:127)会等到日志系统当前没有在执行提交,并且日志中有足够未被预留的空间可以容纳这次系统调用要写入的数据后,才继续执行。log.outstanding 记录当前有多少个系统调用预留了日志空间,预留的空间总量是 log.outstanding 乘以 MAXOPBLOCKS。把 log.outstanding 加一既预留了空间,又能避免在这个系统调用期间发生提交。代码保守地假设每个系统调用最多可能写入 MAXOPBLOCKS 个不同的块。
// 在每个文件系统系统调用开始时被调用。
void
begin_op(void)
{
  acquire(&log.lock);
  while(1){
    if(log.committing){
      sleep(&log, &log.lock);
    } else if(log.lh.n + (log.outstanding+1)*MAXOPBLOCKS > LOGSIZE){
      // 这次操作可能耗尽日志空间;等待提交。
      sleep(&log, &log.lock);
    } else {
      log.outstanding += 1;
      release(&log.lock);
      break;
    }
  }
}
xv6 中的 log_write(kernel/log.c:215)用作 bwrite 的代理(proxy)。它会在内存中记录该缓冲区对应的块号,为它在硬盘的日志中预留一个槽位,同时把这个缓冲区固定在缓冲区缓存中,防止缓存把它逐出。这个缓冲区必须一直保留在缓存中直到提交为止:在此之前,缓存中的数据是唯一的修改记录;在提交之前不能把它写回硬盘上原来的位置;而且同一笔事务中的其他读取也必须能看到这些修改。
log_write 会侦测在同一笔事务中是否多次写入了同一个缓冲区,并让该缓冲区重复使用同一个日志槽位,这项优化常被称为吸收(absorption)。这种情况很常见,例如:保存多个文件 inode 的那个块在同一笔事务里可能会被写入好几次。通过把多次硬盘写入合并成一次,文件系统可以节省日志空间,并提升性能,因为最后只需要把一个块的副本写入硬盘。
// 调用者已经修改了 b->data,并且用完了这个缓冲区。
// 记录块号,并通过增加 refcnt 把缓冲区钉在缓存中。
// 真正写入硬盘的动作由 commit()/write_log() 完成。
//
// log_write() 取代 bwrite();典型用法是:
//   bp = bread(...)
//   modify bp->data[]
//   log_write(bp)
//   brelse(bp)
void
log_write(struct buf *b)
{
  int i;

  acquire(&log.lock);
  if (log.lh.n >= LOGSIZE || log.lh.n >= log.size - 1)
    panic("too big a transaction");
  if (log.outstanding < 1)
    panic("log_write outside of trans");

  for (i = 0; i < log.lh.n; i++) {
    if (log.lh.block[i] == b->blockno)   // 日志吸收
      break;
  }
  log.lh.block[i] = b->blockno;
  if (i == log.lh.n) {  // 向日志新增一个块?
    bpin(b);
    log.lh.n++;
  }
  release(&log.lock);
}
end_op(kernel/log.c:147)会先把 log.outstanding 减一。如果计数器变成 0,说明这是当前事务中最后一笔未决操作,因此它会调用 commit() 来提交这笔事务:
// 在每个文件系统系统调用结束时被调用。
// 如果这是最后一笔未决操作,就提交。
void
end_op(void)
{
  int do_commit = 0;

  acquire(&log.lock);
  log.outstanding -= 1;
  if(log.committing)
    panic("log.committing");
  if(log.outstanding == 0){
    do_commit = 1;
    log.committing = 1;
  } else {
    // begin_op() 可能正在等待日志空间,
    // 而把 log.outstanding 减一已经减少了
    // 预留空间的量。
    wakeup(&log);
  }
  release(&log.lock);

  if(do_commit){
    // 不持有锁时调用 commit,因为不允许持锁睡眠。
    commit();
    acquire(&log.lock);
    log.committing = 0;
    wakeup(&log);
    release(&log.lock);
  }
}
整个提交过程分为四个阶段:
write_log()(kernel/log.c:179)把该事务中被修改过的每个块从缓冲区缓存复制到硬盘上对应的日志槽位write_head()(kernel/log.c:103)把日志的头部块写入硬盘:这就是提交点,如果系统在这一步之后崩溃,恢复过程会根据日志重放这次事务的写入install_trans(kernel/log.c:69)从日志区段中读出每个块,并将其写入文件系统中正确的位置- 最后
end_op会把日志头部中的计数值写为 0;这个动作必须在下一笔事务开始写入日志块之前完成,否则一旦系统崩溃,恢复时就会错误地把前一笔事务的头部与后一笔事务的日志块搭配使用:
static void
commit()
{
  if (log.lh.n > 0) {
    write_log();     // 把被修改的块从缓存写入日志
    write_head();    // 把头部写入硬盘 -- 真正的提交
    install_trans(0); // 现在把这些写入安装到目标位置
    log.lh.n = 0;
    write_head();    // 从日志中清除这笔事务
  }
}
recover_from_log(kernel/log.c:117)由 initlog(kernel/log.c:55)调用,而 initlog 是在引导阶段由 fsinit(kernel/fs.c:42)调用的,这发生在第一个用户进程运行之前(kernel/proc.c:520)。它会读取日志头部,如果头部显示日志中包含一笔已提交的事务,recover_from_log 就会仿照 end_op 的动作来完成恢复。
static void
recover_from_log(void)
{
  read_head();
  install_trans(1); // 若已提交,则从日志复制到硬盘
  log.lh.n = 0;
  write_head(); // 清除日志
}
在 filewrite(kernel/file.c:135)中可以看到一个使用日志的例子,其事务如下:
begin_op();
ilock(f->ip);
r = writei(f->ip, ...);
iunlock(f->ip);
end_op();
这段代码被包在一个循环中,会把大型写入拆分成一次只写少数几个扇区的多个小事务,以避免日志溢出。调用 writei 的过程会作为这笔事务的一部分写入许多不同的块,包括该文件的 inode、一个或多个位图块,以及一些数据块。
8.7 代码:块分配器
文件和目录的内容保存在磁盘块中,而这些块必须从一个空闲池中分配。xv6 的块分配器在硬盘上维护一张空闲位图(free bitmap),每个块对应其中一个位。位为 0 表示对应的块是空闲的;为 1 表示它正在被使用。创建新文件系统的程序 mkfs 会把引导扇区、超级块、日志块、inode 块以及位图块对应的位都设为 1。
块分配器提供两个函数:balloc 分配一个新的磁盘块,bfree 释放一个块。balloc 中的循环(kernel/fs.c:71)会检查每一个块,从块 0 一直到 sb.size,即文件系统中的块总数。它寻找位图中对应位为 0 的块,表示该块是空闲的。如果 balloc 找到这样的块,就更新位图并返回该块。
为了效率,这个循环被拆成两层。外层循环逐个读入存放位图位的块,内层循环检查单个位图块中所有的 Bits-Per-Block(BPB,每块位数)个位。如果两个进程同时尝试分配块,本来可能发生竞态条件,但缓冲区缓存一次只让一个进程使用某一个位图块,这就避免了这种竞态。
// 分配一个清零的磁盘块。
static uint
balloc(uint dev)
{
  int b, bi, m;
  struct buf *bp;

  bp = 0;
  for(b = 0; b < sb.size; b += BPB){
    bp = bread(dev, BBLOCK(b, sb));
    for(bi = 0; bi < BPB && b + bi < sb.size; bi++){
      m = 1 << (bi % 8);
      if((bp->data[bi/8] & m) == 0){  // 这个块空闲吗?
        bp->data[bi/8] |= m;  // 标记该块已被使用。
        log_write(bp);
        brelse(bp);
        bzero(dev, b + bi);
        return b + bi;
      }
    }
    brelse(bp);
  }
  panic("balloc: out of blocks");
}
bfree(kernel/fs.c:90)找到正确的位图块,并把相应的位清 0。同样地,bread 与 brelse 蕴含的独占使用使程序无须再显式加锁。
与本章后文描述的大部分代码一样,balloc 与 bfree 必须在事务内部调用。
8.8 inode 层
inode 一词有两种相关的含义。它可能指硬盘上的数据结构,其中保存着文件的大小和数据块号的列表;也可能指内存中的 inode,它包含硬盘上 inode 的一份副本,以及内核中需要的额外信息。
硬盘上的 inode 被紧凑地存放在一段称为 inode 块的连续硬盘区域中。每个 inode 的大小都相同,所以给定一个编号 n,很容易找到硬盘上的第 n 个 inode。事实上,正是用这个编号 n——称为 inode 号或 i-number——在实现中标识 inode 的。
硬盘上的 inode 由 struct dinode(kernel/fs.h:32)定义。type 字段区分文件、目录和特殊文件(设备)。类型为 0 表示硬盘上的这个 inode 是空闲的。nlink 字段记录指向该 inode 的目录项数量,以便判断何时应当释放硬盘上的 inode 及其数据块。size 字段记录文件内容的字节数。addrs 数组记录保存文件内容的硬盘块的块号。
// 磁盘上的 inode 结构
struct dinode {
  short type;           // 文件类型
  short major;          // 主设备号(仅 T_DEVICE 使用)
  short minor;          // 次设备号(仅 T_DEVICE 使用)
  short nlink;          // 文件系统中指向该 inode 的链接数
  uint size;            // 文件大小(字节)
  uint addrs[NDIRECT+1];   // 数据块地址
};
内核在内存中用一张名为 itable 的表保存活动中的 inode 集合;struct inode(kernel/file.h:17)是硬盘上 struct dinode 的内存副本。只有当有 C 指针指向某个 inode 时,内核才会在内存中保存这个 inode。ref 字段计数指向该内存 inode 的 C 指针个数,如果引用计数降到 0,内核就把该 inode 从内存中丢弃。iget 和 iput 函数获取和释放指向 inode 的指针,并修改引用计数。指向 inode 的指针可以来自文件描述符、当前工作目录,以及像 exec 这样的临时内核代码。
// inode 的内存副本
struct inode {
  uint dev;           // 设备号
  uint inum;          // inode 号
  int ref;            // 引用计数
  struct sleeplock lock; // 保护此行之后的所有内容
  int valid;          // inode 是否已从硬盘读入?

  short type;         // 磁盘 inode 的副本
  short major;
  short minor;
  short nlink;
  uint size;
  uint addrs[NDIRECT+1];
};

// fs.c:
struct {
  struct spinlock lock;
  struct inode inode[NINODE];
} itable;
xv6 的 inode 代码中有四种锁或类锁机制。itable.lock 保护两条不变式:一个 inode 在 inode 表中最多只出现一次;内存中 inode 的 ref 字段计数的就是内存中指向该 inode 的指针数目。每个内存 inode 都有一个 lock 字段,里面是一把睡眠锁,它保证对该 inode 的各字段(例如文件长度)以及对该 inode 的文件或目录内容块的独占访问。只要 inode 的 ref 大于 0,系统就会把这个 inode 维持在表中,不会把该表项重新用于另一个 inode。最后,每个 inode 都含有一个 nlink 字段(保存在硬盘上,如果该 inode 在内存中,也会被复制到内存),它记录指向该文件的目录项数量;如果链接数大于 0,xv6 就不会释放这个 inode。
iget() 返回的 struct inode 指针保证在对应的 iput() 调用之前一直有效:这个 inode 不会被删除,指针所指向的内存也不会被重新用于另一个 inode。iget() 提供的是非独占访问,因此同一个 inode 可以有多个指针。文件系统代码的许多部分都依赖 iget() 的这一行为,既用它长期持有 inode(作为打开的文件和当前目录),也用它防止竞态条件,从而在处理多个 inode 的代码(例如路径名查找)中避免死锁。
// 在设备 dev 上查找编号为 inum 的 inode,
// 并返回它的内存副本。不给 inode 加锁,
// 也不从硬盘读取它。
static struct inode*
iget(uint dev, uint inum)
{
  struct inode *ip, *empty;

  acquire(&itable.lock);

  // 该 inode 是否已在表中?
  empty = 0;
  for(ip = &itable.inode[0]; ip < &itable.inode[NINODE]; ip++){
    if(ip->ref > 0 && ip->dev == dev && ip->inum == inum){
      ip->ref++;
      release(&itable.lock);
      return ip;
    }
    if(empty == 0 && ip->ref == 0)    // 记住空闲槽位。
      empty = ip;
  }

  // 回收一个 inode 表项。
  if(empty == 0)
    panic("iget: no inodes");

  ip = empty;
  ip->dev = dev;
  ip->inum = inum;
  ip->ref = 1;
  ip->valid = 0;
  release(&itable.lock);

  return ip;
}

...

// 释放对一个内存 inode 的引用。
// 如果那是最后一个引用,inode 表项就可以
// 被回收。
// 如果那既是最后一个引用,该 inode 又没有任何
// 链接指向它,就在硬盘上释放这个 inode(及其内容)。
// 所有对 iput() 的调用都必须位于事务内,
// 因为它可能要释放这个 inode。
void
iput(struct inode *ip)
{
  acquire(&itable.lock);

  if(ip->ref == 1 && ip->valid && ip->nlink == 0){
    // inode 没有链接指向它,也没有其他引用:截断并释放。

    // ip->ref == 1 意味着没有其他进程可能持有 ip 的锁,
    // 所以这次 acquiresleep() 不会阻塞(或死锁)。
    acquiresleep(&ip->lock);

    release(&itable.lock);

    itrunc(ip);
    ip->type = 0;
    iupdate(ip);
    ip->valid = 0;

    releasesleep(&ip->lock);

    acquire(&itable.lock);
  }

  ip->ref--;
  release(&itable.lock);
}
iget 返回的 struct inode 可能不包含任何有用的内容。为了确保其中含有硬盘上 inode 的副本,代码必须调用 ilock。ilock 会锁住这个 inode(使其他进程无法再对它执行 ilock),并在尚未读取时从硬盘读入该 inode。iunlock 释放该 inode 上的锁。把获取 inode 指针与加锁分开,有助于在某些情况下避免死锁,例如目录查找期间。多个进程可以同时持有 iget 返回的指向某个 inode 的 C 指针,但同一时刻只能有一个进程锁住该 inode。
// 锁住给定的 inode。
// 必要时从硬盘读取该 inode。
void
ilock(struct inode *ip)
{
  struct buf *bp;
  struct dinode *dip;

  if(ip == 0 || ip->ref < 1)
    panic("ilock");

  acquiresleep(&ip->lock);

  if(ip->valid == 0){
    bp = bread(ip->dev, IBLOCK(ip->inum, sb));
    dip = (struct dinode*)bp->data + ip->inum%IPB;
    ip->type = dip->type;
    ip->major = dip->major;
    ip->minor = dip->minor;
    ip->nlink = dip->nlink;
    ip->size = dip->size;
    memmove(ip->addrs, dip->addrs, sizeof(ip->addrs));
    brelse(bp);
    ip->valid = 1;
    if(ip->type == 0)
      panic("ilock: no type");
  }
}
inode 表只保存那些被内核代码或数据结构持有 C 指针的 inode。它的主要工作是协调多个进程的访问。inode 表恰好也缓存了频繁使用的 inode,但缓存是次要的;如果一个 inode 被频繁使用,缓冲区缓存多半也会把它留在内存中。修改内存中 inode 的代码要用 iupdate 把它写回硬盘。
// 把修改过的内存 inode 复制到硬盘。
// 每次修改 ip->xxx 中那些保存在硬盘上的字段之后
// 都必须调用它。
// 调用者必须持有 ip->lock。
void
iupdate(struct inode *ip)
{
  struct buf *bp;
  struct dinode *dip;

  bp = bread(ip->dev, IBLOCK(ip->inum, sb));
  dip = (struct dinode*)bp->data + ip->inum%IPB;
  dip->type = ip->type;
  dip->major = ip->major;
  dip->minor = ip->minor;
  dip->nlink = ip->nlink;
  dip->size = ip->size;
  memmove(dip->addrs, ip->addrs, sizeof(ip->addrs));
  log_write(bp);
  brelse(bp);
}
8.9 代码:inode
要分配一个新的 inode(例如创建文件时),xv6 会调用 ialloc(kernel/fs.c:196)。ialloc 与 balloc 类似:它一次一个块地遍历硬盘上的 inode 结构,寻找一个被标记为空闲的 inode。当它找到一个时,就把新的 type 写入硬盘以声明占用该 inode,然后通过尾调用 iget(kernel/fs.c:210)返回 inode 表中的一个表项。ialloc 能够正确运行,依赖于同一时刻只有一个进程持有对 bp 的引用这一事实:这样 ialloc 就能确信没有其他进程同时看到这个 inode 可用并试图占用它。
// 在设备 dev 上分配一个 inode。
// 通过给它指定 type 把它标记为已分配。
// 返回一个未加锁、但已分配且有引用的 inode。
struct inode*
ialloc(uint dev, short type)
{
  int inum;
  struct buf *bp;
  struct dinode *dip;

  for(inum = 1; inum < sb.ninodes; inum++){
    bp = bread(dev, IBLOCK(inum, sb));
    dip = (struct dinode*)bp->data + inum%IPB;
    if(dip->type == 0){  // 一个空闲 inode
      memset(dip, 0, sizeof(*dip));
      dip->type = type;
      log_write(bp);   // 在硬盘上把它标记为已分配
      brelse(bp);
      return iget(dev, inum);
    }
    brelse(bp);
  }
  panic("ialloc: no inodes");
}
iget(kernel/fs.c:243)在 inode 表中查找具有目标设备号和 inode 号的活跃表项(ip->ref > 0)。如果找到,就返回指向该 inode 的一个新引用(kernel/fs.c:252-256)。iget 在扫描时记录第一个空闲槽位的位置(kernel/fs.c:257-258),当需要分配一个表项时就会使用它。
// 在设备 dev 上查找编号为 inum 的 inode,
// 并返回它的内存副本。不给 inode 加锁,
// 也不从硬盘读取它。
static struct inode*
iget(uint dev, uint inum)
{
  struct inode *ip, *empty;

  acquire(&itable.lock);

  // 该 inode 是否已在表中?
  empty = 0;
  for(ip = &itable.inode[0]; ip < &itable.inode[NINODE]; ip++){
    if(ip->ref > 0 && ip->dev == dev && ip->inum == inum){
      ip->ref++;
      release(&itable.lock);
      return ip;
    }
    if(empty == 0 && ip->ref == 0)    // 记住空闲槽位。
      empty = ip;
  }

  // 回收一个 inode 表项。
  if(empty == 0)
    panic("iget: no inodes");

  ip = empty;
  ip->dev = dev;
  ip->inum = inum;
  ip->ref = 1;
  ip->valid = 0;
  release(&itable.lock);

  return ip;
}
在读取或写入 inode 的元数据或内容之前,代码必须先用 ilock 给 inode 加锁。ilock(kernel/fs.c:289)为此使用一把睡眠锁。一旦 ilock 获得了对该 inode 的独占访问,它就在需要时从硬盘(更可能是缓冲区缓存)读取该 inode。iunlock 函数(kernel/fs.c:317)释放这把睡眠锁,这可能使正在睡眠的进程被唤醒。
// 锁住给定的 inode。
// 必要时从硬盘读取该 inode。
void
ilock(struct inode *ip)
{
  struct buf *bp;
  struct dinode *dip;

  if(ip == 0 || ip->ref < 1)
    panic("ilock");

  acquiresleep(&ip->lock);

  if(ip->valid == 0){
    bp = bread(ip->dev, IBLOCK(ip->inum, sb));
    dip = (struct dinode*)bp->data + ip->inum%IPB;
    ip->type = dip->type;
    ip->major = dip->major;
    ip->minor = dip->minor;
    ip->nlink = dip->nlink;
    ip->size = dip->size;
    memmove(ip->addrs, dip->addrs, sizeof(ip->addrs));
    brelse(bp);
    ip->valid = 1;
    if(ip->type == 0)
      panic("ilock: no type");
  }
}

// 解锁给定的 inode。
void
iunlock(struct inode *ip)
{
  if(ip == 0 || !holdingsleep(&ip->lock) || ip->ref < 1)
    panic("iunlock");

  releasesleep(&ip->lock);
}
iput(kernel/fs.c:333)通过把引用计数减一(kernel/fs.c:356)来释放指向某个 inode 的 C 指针。如果这是最后一个引用,该 inode 在 inode 表中的槽位就此空闲,可以被另一个 inode 复用。
如果 iput 发现没有任何 C 指针引用某个 inode,并且该 inode 也没有链接指向它(它不出现在任何目录中),那么就必须释放这个 inode 及其数据块。iput 调用 itrunc 把文件截断为零字节,从而释放数据块;把 inode 的类型设为 0(未分配);并把 inode 写入硬盘(kernel/fs.c:338)。
iput 在释放 inode 时的加锁协议值得进一步细看。一种危险是:并发的线程可能正在 ilock 中等待使用这个 inode(例如读取文件或列出目录内容),而它并没有准备好应对该 inode 已被取消分配的情况。这不会发生,因为如果一个 inode 没有任何链接指向它、且 ip->ref 为 1,那么系统调用就没有办法取得指向这个内存 inode 的指针。这唯一一个引用,正是调用 iput 的线程所持有的那个引用。iput 确实是在 itable.lock 的临界区之外检查引用计数是否为 1 的,但此时链接数已经确定为 0,所以不会有线程试图获取新的引用。
另一种主要危险是:并发的 ialloc 调用可能选中 iput 正在释放的那个 inode。这只会发生在 iupdate 把硬盘上该 inode 的 type 写成 0(未分配)之后。这个竞态条件是良性的;负责分配的线程在读写该 inode 之前会礼貌地等待获取该 inode 的睡眠锁,而到那时 iput 已经不再使用它了。
iput() 可以写硬盘。这意味着任何使用文件系统的系统调用都可能写硬盘,因为该系统调用可能正是最后一个持有该文件引用的调用。即使是像 read() 这样看似只读的调用,最终也可能调用到 iput()。这又意味着,即使是只读的系统调用,只要它们使用文件系统,就必须包在事务里。
iput() 与崩溃之间存在一种棘手的相互影响。当文件的链接数降到 0 时,iput() 不会立即截断该文件,因为某些进程可能仍在内存中持有对该 inode 的引用:这个进程可能仍在读写该文件,因为它已经成功地打开了它。但是,如果在最后一个进程关闭该文件的文件描述符之前发生崩溃,那么该文件在硬盘上仍会被标记为已分配,却没有任何目录项指向它。
文件系统用两种方式之一处理这种情况。简单的办法是:重启之后,在恢复阶段扫描整个文件系统,找出那些被标记为已分配、但没有目录项指向它们的文件。只要存在这样的文件,就可以把它们释放掉。
第二种办法不需要扫描文件系统。在这种办法中,文件系统把某个文件的 inode 号记录在硬盘上(例如记录在超级块中),这个文件的链接数已降到 0,但引用计数还不为 0。当引用计数也降到 0、文件系统真正删除该文件时,它就更新硬盘上的这个列表,把该 inode 从中移除。在恢复阶段,文件系统会释放列表中留下的任何文件。
xv6 两种方案都没有实现,这意味着 inode 可能已在硬盘上被标记为已分配,尽管它们已经不再被使用。这意味着随着时间推移,xv6 有耗尽硬盘空间的风险。
8.10 代码:inode 的内容
硬盘上的 inode 结构 struct dinode 包含一个 size 和一个块号数组(见图 8.3)。inode 的数据保存在 dinode 的 addrs 数组所列出的块中。前 NDIRECT 个数据块列在数组的前 NDIRECT 个条目中;这些块称为直接块。接下来的 NINDIRECT 个数据块不列在 inode 中,而是列在一个称为间接块的数据块中。
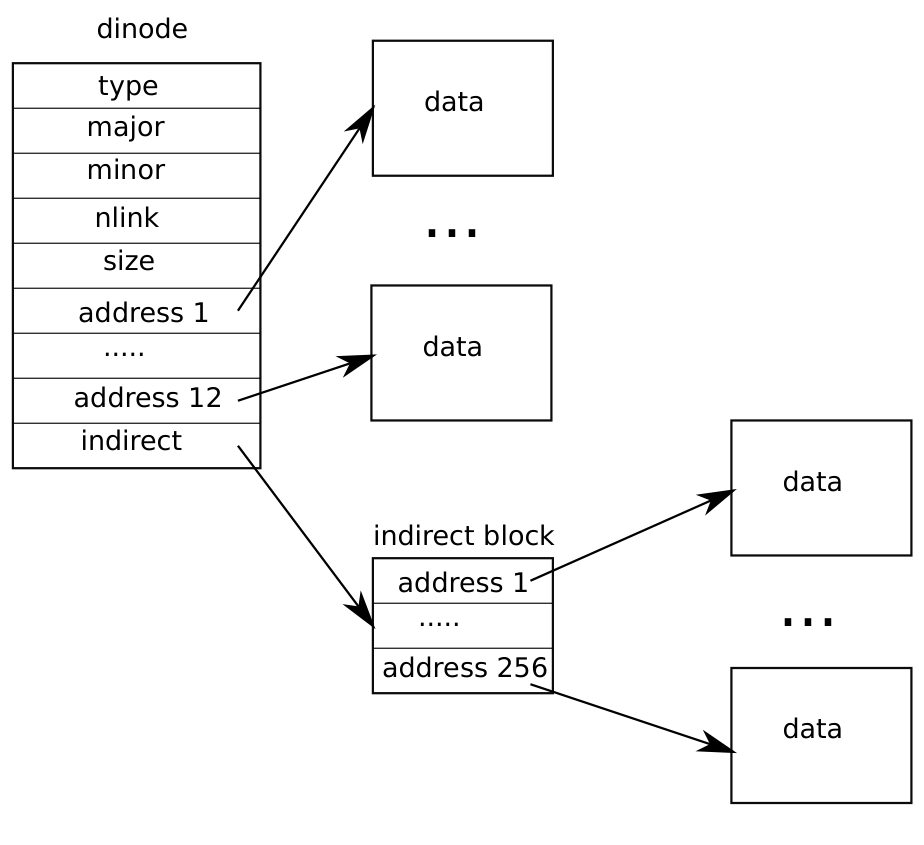
addrs 数组的最后一个条目给出间接块的地址。因此,一个文件最前面的 12 kB(NDIRECT × BSIZE)字节可以从 inode 中列出的块读入,而其后的 256 kB(NINDIRECT × BSIZE)字节必须先查询间接块才能读入。这是一种很好的硬盘表示方式,但对调用者来说却相当复杂。bmap 函数负责管理这种表示方式,使得更高层的例程(例如我们马上就会看到的 readi 和 writei)无须处理这种复杂性。bmap 返回 inode ip 的第 bn 个数据块对应的硬盘块号。如果 ip 还没有这样的块,bmap 就分配一个。
bmap 函数(kernel/fs.c:378)先解决简单情形:前 NDIRECT 个块直接列在 inode 中(kernel/fs.c:383-387)。接下来的 NINDIRECT 个块列在 ip->addrs[NDIRECT] 处的间接块中。bmap 读取这个间接块(kernel/fs.c:394),然后从块内正确的位置读出一个块号(kernel/fs.c:395)。如果块号超过 NDIRECT+NINDIRECT,bmap 就 panic;writei 中含有防止这种情况发生的检查(kernel/fs.c:494)。
// inode 的内容
//
// 每个 inode 相关联的内容(数据)保存在硬盘的块中。
// 前 NDIRECT 个块号列在 ip->addrs[] 中。接下来的
// NINDIRECT 个块列在块 ip->addrs[NDIRECT] 中。

// 返回 inode ip 中第 n 个块对应的硬盘块地址。
// 如果没有这样的块,bmap 会分配一个。
static uint
bmap(struct inode *ip, uint bn)
{
  uint addr, *a;
  struct buf *bp;

  if(bn < NDIRECT){
    if((addr = ip->addrs[bn]) == 0)
      ip->addrs[bn] = addr = balloc(ip->dev);
    return addr;
  }
  bn -= NDIRECT;

  if(bn < NINDIRECT){
    // 读入间接块,必要时先分配。
    if((addr = ip->addrs[NDIRECT]) == 0)
      ip->addrs[NDIRECT] = addr = balloc(ip->dev);
    bp = bread(ip->dev, addr);
    a = (uint*)bp->data;
    if((addr = a[bn]) == 0){
      a[bn] = addr = balloc(ip->dev);
      log_write(bp);
    }
    brelse(bp);
    return addr;
  }

  panic("bmap: out of range");
}
bmap 按需分配块。ip->addrs[] 中或间接块里的某个条目为 0,表示还没有分配块。当 bmap 遇到 0 时,就用新分配的块号替换它们,这些块按需分配(kernel/fs.c:384-385)(kernel/fs.c:392-393)。
itrunc 释放一个文件所占用的块,并把 inode 的大小重置为零。itrunc(kernel/fs.c:410)先释放直接块(kernel/fs.c:416-421),再释放间接块中列出的那些块(kernel/fs.c:426-429),最后释放间接块本身(kernel/fs.c:431-432)。
// 截断 inode(丢弃其内容)。
// 调用者必须持有 ip->lock。
void
itrunc(struct inode *ip)
{
  int i, j;
  struct buf *bp;
  uint *a;

  for(i = 0; i < NDIRECT; i++){
    if(ip->addrs[i]){
      bfree(ip->dev, ip->addrs[i]);
      ip->addrs[i] = 0;
    }
  }

  if(ip->addrs[NDIRECT]){
    bp = bread(ip->dev, ip->addrs[NDIRECT]);
    a = (uint*)bp->data;
    for(j = 0; j < NINDIRECT; j++){
      if(a[j])
        bfree(ip->dev, a[j]);
    }
    brelse(bp);
    bfree(ip->dev, ip->addrs[NDIRECT]);
    ip->addrs[NDIRECT] = 0;
  }

  ip->size = 0;
  iupdate(ip);
}
bmap 让 readi 和 writei 能够方便地访问 inode 的数据。readi(kernel/fs.c:456)一开始会先确认偏移量和长度没有超出文件末尾。从文件末尾之后开始的读操作返回错误(kernel/fs.c:461-462),而从文件末尾处开始或越过末尾的读操作返回的字节数少于请求的数目(kernel/fs.c:463-464)。主循环处理文件的每一个块,把数据从缓冲区拷贝到 dst(kernel/fs.c:466-475)。
// 从 inode 读取数据。
// 调用者必须持有 ip->lock。
// 如果 user_dst==1,那么 dst 是一个用户虚拟地址;
// 否则 dst 是一个内核地址。
int
readi(struct inode *ip, int user_dst, uint64 dst, uint off, uint n)
{
  uint tot, m;
  struct buf *bp;

  if(off > ip->size || off + n < off)
    return 0;
  if(off + n > ip->size)
    n = ip->size - off;

  for(tot=0; tot<n; tot+=m, off+=m, dst+=m){
    bp = bread(ip->dev, bmap(ip, off/BSIZE));
    m = min(n - tot, BSIZE - off%BSIZE);
    if(either_copyout(user_dst, dst, bp->data + (off % BSIZE), m) == -1) {
      brelse(bp);
      tot = -1;
      break;
    }
    brelse(bp);
  }
  return tot;
}
writei(kernel/fs.c:487)与 readi 完全相同,只有三个例外:从文件末尾处开始或越过末尾的写会使文件增长,最多增长到最大文件长度(kernel/fs.c:494-495);循环把数据拷入缓冲区而不是拷出(kernel/fs.c:500);如果写入扩展了文件,writei 还必须更新文件的长度(kernel/fs.c:508-509)。
// 把数据写入 inode。
// 调用者必须持有 ip->lock。
// 如果 user_src==1,那么 src 是一个用户虚拟地址;
// 否则 src 是一个内核地址。
// 返回成功写入的字节数。
// 如果返回值小于请求的 n,说明发生了某种错误。
int
writei(struct inode *ip, int user_src, uint64 src, uint off, uint n)
{
  uint tot, m;
  struct buf *bp;

  if(off > ip->size || off + n < off)
    return -1;
  if(off + n > MAXFILE*BSIZE)
    return -1;

  for(tot=0; tot<n; tot+=m, off+=m, src+=m){
    bp = bread(ip->dev, bmap(ip, off/BSIZE));
    m = min(n - tot, BSIZE - off%BSIZE);
    if(either_copyin(bp->data + (off % BSIZE), user_src, src, m) == -1) {
      brelse(bp);
      break;
    }
    log_write(bp);
    brelse(bp);
  }

  if(off > ip->size)
    ip->size = off;

  // 即使大小没有变化,也要把 inode 写回硬盘,
  // 因为上面的循环可能已经调用 bmap(),
  // 往 ip->addrs[] 中加入了一个新块。
  iupdate(ip);

  return tot;
}
readi 和 writei 都以检查 ip->type == T_DEV 开头。这种情况处理数据不存放在文件系统中的特殊设备;我们将在文件描述符层再回到这种情况。
stati 函数(kernel/fs.c:442)把 inode 的元数据拷贝到 stat 结构中,该结构通过 stat 系统调用暴露给用户程序。
struct stat {
  int dev;     // 文件系统的硬盘设备
  uint ino;    // inode 号
  short type;  // 文件类型
  short nlink; // 指向该文件的链接数
  uint64 size; // 文件大小(字节)
};
8.11 代码:目录层
目录的实现方式和一般文件非常类似。它的 inode 类型为 T_DIR,其数据部分则是一连串的目录项(directory entry)。每个目录项是一个 struct dirent(kernel/fs.h:56),其中包含了一个名称以及一个 inode 编号。名称最多为 DIRSIZ(14)个字符;若长度不足,则以 NUL(0)字节作为结尾。inode 编号为零的目录项被视为未使用的空闲目录项。
// 目录是一个文件,其中包含一连串 dirent 结构。
#define DIRSIZ 14

struct dirent {
  ushort inum;
  char name[DIRSIZ];
};
dirlookup 函数(kernel/fs.c:530)会在某个目录(dp)中搜索名称符合指定字符串的目录项。若找到了,就会返回对应 inode 的指针(未加锁),并将 *poff 设为该目录项在该目录中所对应的字节偏移量,这是为了让调用者可以对该目录项进行修改。如果 dirlookup 成功找到对应名称的目录项,它会更新 *poff,并通过 iget 取得该 inode 并返回(仍是未加锁状态)。
// 在目录中查找一个目录项。
// 若找到,把 *poff 设为该目录项的字节偏移量。
struct inode*
dirlookup(struct inode *dp, char *name, uint *poff)
{
  uint off, inum;
  struct dirent de;

  if(dp->type != T_DIR)
    panic("dirlookup not DIR");

  for(off = 0; off < dp->size; off += sizeof(de)){
    if(readi(dp, 0, (uint64)&de, off, sizeof(de)) != sizeof(de))
      panic("dirlookup read");
    if(de.inum == 0)
      continue;
    if(namecmp(name, de.name) == 0){
      // 目录项与路径元素匹配
      if(poff)
        *poff = off;
      inum = de.inum;
      return iget(dp->dev, inum);
    }
  }

  return 0;
}
dirlookup 正是 iget 返回“未加锁”inode 的原因,因为调用 dirlookup 的调用者已经先对 dp 上锁了,因此如果查找的是 .(代表当前目录的别名),在返回前试图再次对该 inode 上锁,就会导致对 dp 的重复上锁并造成死锁。实际上还有更复杂的死锁情境,涉及多个进程与 ..(父目录的别名),所以 . 并不是唯一的问题。因此正确做法是让调用者在收到 inode 后先解锁 dp,再去对 ip 上锁,以确保任一时刻只持有一个锁。
dirlink 函数(kernel/fs.c:557)会将一个新的目录项写入指定的目录 dp,这个目录项具有指定的名称与 inode 编号。如果目录中已存在该名称,则 dirlink 会返回一个错误(kernel/fs.c:563-567)。
主循环会扫描所有目录项以寻找尚未被分配(未使用)的目录项。一旦找到,就会提前结束循环(kernel/fs.c:573-574),并将 off 设为该可用目录项的偏移量。若找不到空的目录项,循环就会结束,这时 off 会被设成 dp->size。无论是哪种情况,dirlink 都会在 off 所指定的位置写入新的目录项(kernel/fs.c:577-580)。
// 将一个新的目录项 (name, inum) 写入目录 dp。
int
dirlink(struct inode *dp, char *name, uint inum)
{
  int off;
  struct dirent de;
  struct inode *ip;

  // 检查该名称尚不存在。
  if((ip = dirlookup(dp, name, 0)) != 0){
    iput(ip);
    return -1;
  }

  // 寻找一个空的 dirent。
  for(off = 0; off < dp->size; off += sizeof(de)){
    if(readi(dp, 0, (uint64)&de, off, sizeof(de)) != sizeof(de))
      panic("dirlink read");
    if(de.inum == 0)
      break;
  }

  strncpy(de.name, name, DIRSIZ);
  de.inum = inum;
  if(writei(dp, 0, (uint64)&de, off, sizeof(de)) != sizeof(de))
    panic("dirlink");

  return 0;
}
8.12 代码:路径名
路径名称查找的过程会依序针对路径中的每个组件调用一次 dirlookup。namei 函数(kernel/fs.c:664)会解析 path 并返回对应的 inode。而 nameiparent 则是另一种变形版本:它会在处理到最后一个路径组件之前停止,返回该路径的父目录所对应的 inode,并将最后一个组件拷贝到变量 name 中。这两个函数都会调用一个通用的底层函数 namex 来进行实际的查找工作。
struct inode*
namei(char *path)
{
  char name[DIRSIZ];
  return namex(path, 0, name);
}

struct inode*
nameiparent(char *path, char *name)
{
  return namex(path, 1, name);
}
namex 函数(kernel/fs.c:629)一开始会判断该从哪里开始进行路径的解析。如果 path 是以 / 开头,代表从根目录开始解析;否则就从目前所在的目录开始(kernel/fs.c:633-636)。接着,它会使用 skipelem 依序取得路径中的每个元素(kernel/fs.c:638)。每次循环都会在当前的 inode ip 中查找这个名称。每一轮开始时,它会先对 ip 上锁,并确认它的类型是否为目录。若不是,就会导致查找失败(kernel/fs.c:639-643)。对 ip 上锁的目的并不是害怕 ip->type 可能会在背后被改变(这其实不会发生),而是因为在执行 ilock 前,我们无法保证 ip->type 已经从硬盘加载进来了。
如果调用的是 nameiparent,且这已经是路径上的最后一个元素了,则依据其设计,会提前结束查找;最后一个元素已经拷贝到 name 中,因此 namex 只需返回未加锁的 ip(kernel/fs.c:644-648)即可。最后,这个循环会通过 dirlookup 查找当前元素,并通过设置 ip = next 来进入下一轮查找(kernel/fs.c:649-654)。当所有路径元素都处理完后,会返回 ip。
// 查找路径名称并返回对应的 inode。
// 如果 parent != 0,返回父目录的 inode,并把最后一个路径
// 元素拷贝到 name 中,name 必须有容纳 DIRSIZ 个字节的空间。
// 必须在 transaction 内调用,因为它会调用 iput()。
static struct inode*
namex(char *path, int nameiparent, char *name)
{
  struct inode *ip, *next;

  if(*path == '/')
    ip = iget(ROOTDEV, ROOTINO);
  else
    ip = idup(myproc()->cwd);

  while((path = skipelem(path, name)) != 0){
    ilock(ip);
    if(ip->type != T_DIR){
      iunlockput(ip);
      return 0;
    }
    if(nameiparent && *path == '\0'){
      // 提前一层结束。
      iunlock(ip);
      return ip;
    }
    if((next = dirlookup(ip, name, 0)) == 0){
      iunlockput(ip);
      return 0;
    }
    iunlockput(ip);
    ip = next;
  }
  if(nameiparent){
    iput(ip);
    return 0;
  }
  return ip;
}
namex 的整体流程可能需要相当长的时间,因为它可能要进行多次硬盘操作,来读取路径中经过的那些目录的 inode 和目录块(如果这些数据尚未被缓存在缓冲区缓存中)。xv6 的设计十分谨慎:即使某个内核线程调用 namex 时被卡在硬盘 I/O 上,其他内核线程若要查找不同的路径名仍然可以继续运行。这是因为 namex 会针对路径中的每个目录分别上锁,让不同目录的查找可以并行进行。
这样的并行设计也带来了一些挑战。举例来说,当某个内核线程正在查找某个路径时,另一个内核线程可能正在通过 unlink 操作来修改整个目录树。这样就会出现一种风险:查找的线程可能会处理到某个已经被删除、其块又被重新分配给其他目录或文件的目录。
xv6 采取了一些机制来避免这种竞态条件。举例来说,在 namex 执行 dirlookup 时,查找的线程会先持有该目录的锁,并且 dirlookup 返回的 inode 是通过 iget 取得的,而 iget 会增加该 inode 的引用计数。只有在 namex 收到 inode 之后,才会释放对该目录的锁。这样一来,即使之后有另一个线程把这个 inode 从目录中 unlink 掉,由于 inode 的引用计数尚未归零,xv6 仍然不会删除该 inode。
另一种风险是死锁。例如,在查找 .(代表当前目录)时,next 会指向与 ip 相同的 inode。若在还没释放 ip 的锁之前就尝试去锁住 next,就会造成死锁。为了避免这种情况,namex 会先解锁该目录,再去对 next 上锁。这也再次说明了将 iget 与 ilock 拆开设计的重要性。
8.13 文件描述符层
Unix 接口有一个很酷的设计是,它将系统中的大多数资源都表示为文件,包括控制台(console)这样的设备、管道,当然还有真实文件。而实现这种一致性设计的就是文件描述符层。
如同在第 1 章所介绍的,xv6 为每个进程提供了自己的“已打开文件表(open file table)”,也就是文件描述符表。每个被打开的文件都会对应到一个 struct file(kernel/file.h:1),这个结构包装住了一个 inode 或一个管道,再加上一个 I/O 偏移量。每次调用 open 都会创建一个新的打开文件(也就是一个新的 struct file 结构);即便多个进程打开同一个文件,它们各自的 struct file 也会拥有不同的 I/O 偏移量。
相对地,如果同一个 struct file 被多次引用,它可能会多次出现在同一个进程的文件表中,也可能出现在不同进程的文件表中。这种情况可能发生在进程使用 open 打开文件后,通过 dup 创建别名,或通过 fork 和子进程共享文件的时候。系统会通过引用计数来追踪某个打开文件被引用的次数。文件可以被打开为可读、可写,或两者皆可,这些权限状态由 readable 与 writable 字段记录。
struct file {
  enum { FD_NONE, FD_PIPE, FD_INODE, FD_DEVICE } type;
  int ref; // 引用计数
  char readable;
  char writable;
  struct pipe *pipe; // FD_PIPE
  struct inode *ip;  // FD_INODE 和 FD_DEVICE
  uint off;          // FD_INODE
  short major;       // FD_DEVICE
};
系统中所有打开的文件都会集中管理在一个全局的文件表 ftable 中。这个文件表提供几个操作函数,包括分配一个新的文件结构(filealloc)、创建重复引用(filedup)、释放引用(fileclose),以及进行数据读写的函数(fileread 与 filewrite)。
struct {
  struct spinlock lock;
  struct file file[NFILE];
} ftable;
前三个函数采用了我们已经熟悉的形式。filealloc(kernel/file.c:30)会扫描整个文件表,寻找一个尚未被引用的文件(即 f->ref == 0),引用它并返回该新引用;filedup(kernel/file.c:48)会增加引用计数;而 fileclose(kernel/file.c:60)则会减少引用计数。当某个文件的引用计数变成 0 时,fileclose 会依据其类型(管道或 inode)释放底层资源。
filestat、fileread 与 filewrite 这些函数实现了对文件的 stat、read 与 write 操作。filestat(kernel/file.c:88)只能作用于 inode,并会调用 stati。fileread 与 filewrite 则会先检查该操作是否符合文件的打开模式,然后将调用转发给对应的管道或 inode 操作实现。如果该文件表示的是一个 inode,fileread 与 filewrite 就会使用 I/O 偏移量作为此次操作的偏移,并在操作完成后推进偏移量(kernel/file.c:122-123、kernel/file.c:153-154)。而管道则没有偏移量的概念。
请注意,inode 函数要求调用者自己负责加锁(kernel/file.c:94-96、kernel/file.c:121-124、kernel/file.c:163-166)。这个 inode 加锁的设计还带来一个额外好处:它能确保读写时的偏移量更新具有原子性,也就是说多个进程同时写入同一文件时,不会互相覆盖对方的数据;不过写入的内容可能会交错。
8.14 代码:系统调用
借助底层提供的那些函数,大多数系统调用的实现都非常简单(kernel/sysfile.c)。不过有几个系统调用值得我们深入探讨。
sys_link 和 sys_unlink 这两个函数会修改目录,也就是创建或移除对 inode 的引用,它们是“使用 transaction 的强大能力的又一个好例子”。sys_link(kernel/sysfile.c:120)首先会取得两个字符串参数 old 和 new(kernel/sysfile.c:125)。假设 old 存在且不是目录(kernel/sysfile.c:129-132),sys_link 就会把它的 ip->nlink 引用计数加一。
接着 sys_link 会调用 nameiparent 找出 new 的父目录与最后一段名称(kernel/sysfile.c:145),然后在该目录中创建一个新的目录项指向 old 的 inode(kernel/sysfile.c:148)。这个新的父目录必须存在,且必须和 old 的 inode 在同一个设备上,因为 inode 编号只有在单一硬盘上才具有唯一性。如果出现这类错误,sys_link 必须回头把 ip->nlink 减回来。
使用 transaction 会让实现变得更简单,因为它牵涉到更新多个磁盘块,但我们不需要担心这些操作的执行顺序:它们要么全部成功,要么全都不执行。例如,如果没有使用 transaction,就先更新了 ip->nlink 却还没创建新的链接,这会让文件系统短暂进入不一致状态,若此时系统崩溃,可能会造成更严重的错误。而有了 transaction,就不需要担心这些问题。
sys_link 是为已存在的 inode 创建一个新名称,而 create(kernel/sysfile.c:242)则会为一个新 inode 创建新名称。create 是三个与创建文件相关的系统调用的泛化版本:open 搭配 O_CREATE 标志会创建一个新的普通文件、mkdir 创建新目录、mkdev 则创建设备文件。
create 的起始步骤与 sys_link 相同,会先调用 nameiparent 找到父目录 inode。接着调用 dirlookup 确认该名称是否已存在(kernel/sysfile.c:252)。若名称已存在,create 的行为会根据所使用的系统调用而异:open 的语义和 mkdir、mkdev 不同。如果 create 是代表 open 调用(type == T_FILE),而该名称对应的本身就是一个普通文件,则 open 视此为成功,create 也会视为成功(kernel/sysfile.c:256);否则会视为错误(kernel/sysfile.c:257-258)。
若名称尚未存在,create 就会使用 ialloc(kernel/sysfile.c:261)分配一个新的 inode。若这个新的 inode 是一个目录,create 会初始化它的 . 与 .. 目录项。当这些数据都妥善初始化后,create 才会将该 inode 链接到父目录中(kernel/sysfile.c:274)。create 与 sys_link 一样,在过程中会同时持有两个 inode 的锁:ip 与 dp。但不会有死锁的风险,因为 ip 是刚分配出来的新 inode,系统中不会有其他进程已经先锁住它并再去锁 dp。
通过 create,可以很容易地实现 sys_open、sys_mkdir 和 sys_mknod。其中 sys_open(kernel/sysfile.c:287)最为复杂,因为“创建新文件”只是它众多功能中的一小部分。当 open 搭配 O_CREATE 标志时,它会调用 create(kernel/sysfile.c:301);否则就会调用 namei(kernel/sysfile.c:307)。
create 会返回一个已加锁的 inode,但 namei 不会,因此 sys_open 必须自行将该 inode 上锁。这里也刚好提供了一个机会来检查是否对目录做了不合法的打开方式(目录只能以读方式打开,不能以写方式打开)。在成功取得 inode 之后,sys_open 会分配一个文件与一个文件描述符(kernel/sysfile.c:325),并填入文件的内容(kernel/sysfile.c:337-342)。需要注意的是,此时该文件只存在于当前进程的文件表中,因此其他进程无法访问这个尚未完全初始化的文件。
在第 7 章,我们在尚未介绍文件系统之前就已经看过管道的实现。而 sys_pipe 则将那套管道实现与文件系统结合,提供一种创建管道对(pipe pair)的方法。它的参数是一个指向两个整数的内存空间的指针,该函数会在那里写入两个新的文件描述符。接着,它会分配一个新的管道,并将两个文件描述符安装进进程的文件描述符表中。
8.15 现实世界
现实世界中的操作系统所使用的缓冲区缓存(buffer cache)比 xv6 的复杂得多,但其目的仍然有两个:缓存数据,以及同步访问硬盘。xv6 的缓冲区缓存和早期 UNIX V6 一样,采用简单的最近最少使用(LRU)驱逐策略;实际上可以实现许多更复杂的策略,各自适用于不同的工作负载,但也各有优缺点。更高效的 LRU 缓存可以不使用链表,而是用哈希表做查找、用堆来处理 LRU 驱逐。现代的缓冲区缓存通常还会集成进虚拟内存系统,以支持内存映射文件。
xv6 的日志系统效率不高。它在执行 commit 时无法与其他文件系统的系统调用并行进行。此外,即便只修改了某个块中的几个字节,它仍然会将整个块写入日志。日志的写入是同步进行的,而且每次只能写一个块,这通常需要等整个硬盘旋转一圈的时间。实际的日志系统会处理以上所有这些性能问题。
提供崩溃恢复的方法不只是日志。早期的文件系统会在重启时运行清理程序(scavenger,例如 UNIX 的 fsck 程序),逐一检查所有的文件与目录,并检查块与 inode 的空闲列表,来找出并修复不一致之处。对于大型文件系统,这种清理可能会花上好几小时,而且某些不一致的情况无法以保证系统调用是原子性的方式来修复。而通过日志进行恢复不仅更快,也能让系统调用在发生崩溃时仍保持原子性。
xv6 采用与早期 UNIX 相同的 inode 和目录的磁盘布局;这种结构在这些年来一直非常稳定地被沿用,像 BSD 的 UFS/FFS 和 Linux 的 ext2/ext3 都采用了本质上相同的数据结构。在这个布局中最没有效率的是目录:每次查找都需要线性扫描该目录的所有磁盘块。当目录仅占几个块时这是合理的,但若目录中有大量文件,代价就会很高。而如 Microsoft Windows 的 NTFS、macOS 的 HFS,以及 Solaris 的 ZFS 等系统(这里只是举几个例子),则会将目录实现为硬盘上的平衡树结构。虽然这样的实现较复杂,但能保证目录查找操作在时间上为对数级别。
xv6 对于硬盘错误的处理方式非常简单:只要某次硬盘操作失败,整个系统就会 panic。这样的设计是否合理,取决于底层硬件:若操作系统运行在具有错误容忍(如冗余)机制的特殊硬件上,那么硬盘错误非常少见,panic 或许可以接受。但若操作系统直接面对的是普通硬盘,那么就应预期错误会发生,并以更温和的方式处理,像是确保单一文件中的某个块损毁不会影响整个文件系统的正常使用。
xv6 的限制是文件系统必须完全放在单一硬盘设备上,且大小不可变动。随着大型数据库与多媒体文件推升存储需求,现代操作系统开始寻求突破“一个文件系统只能对应一块硬盘”的瓶颈。最基本的做法是将多块硬盘合并为一个逻辑硬盘。RAID 这种硬件解决方案至今仍最常见,但近年趋势是尽可能地将这些逻辑实现搬到软件层面。
这些软件方案通常支持更灵活的功能,例如能即时添加或移除硬盘,动态扩展或缩减逻辑设备大小。当然,这种可动态调整大小的存储层也需要文件系统本身具备相同能力;而 xv6 中使用固定大小 inode 块数组的设计,在这样的环境下将难以应用。虽然将硬盘管理与文件系统分离是比较干净的设计方式,但两者之间复杂的接口反而使得有些系统(如 Sun 的 ZFS)选择将它们合并设计。
xv6 的文件系统还缺少现代文件系统的许多其他特性;例如,它不支持快照和增量备份。
现代 Unix 系统允许许多不同种类的资源都能通过与硬盘文件相同的系统调用来访问,例如:具名管道、网络连接、远程文件系统,以及像 /proc 这种监控与控制接口。与其像 xv6 的 fileread 与 filewrite 中使用 if 判断处理类型,这些系统通常会为每个打开的文件配一张函数指针表,每个操作(如 read、write)对应一个函数,调用时就直接由该函数指针触发该 inode 所属类型的实现。对于网络文件系统或用户级文件系统而言,这些函数会将调用转换成网络 RPC,等待回应后再返回结果。
8.16 练习
- 为什么在
balloc中要调用 panic?xv6 有办法从这种情况中恢复吗? - 为什么在
ialloc中要调用 panic?xv6 有办法从这种情况中恢复吗? - 为什么
filealloc在没有可用文件结构时不会调用 panic?为什么这种情况比较常见,因此值得特别处理? - 假设在
sys_link中,ip对应的文件在调用iunlock(ip)与dirlink之间,被其他进程 unlink 掉了。这个链接还会被正确创建吗?为什么会或为什么不会? create在过程中会调用四个必须要成功的函数(一次ialloc和三次dirlink)。若其中任一失败,它就会调用 panic。为什么这样的做法是可以接受的?为什么这四个调用不能失败?sys_chdir在调用iput(cp->cwd)之前先调用了iunlock(ip),而iput(cp->cwd)可能会去锁住cp->cwd,不过就算把iunlock(ip)延后到iput之后才执行,也不会造成死锁。为什么?- 实现
lseek这个系统调用。要支持lseek,还需要修改filewrite:当lseek将off设置到超过f->ip->size时,要在文件中用 0 来填补中间的空洞。 - 为
open加上O_TRUNC与O_APPEND支持,这样 shell 里的>与>>操作符才会正常运作。 - 修改文件系统,使其支持符号链接。
- 修改文件系统,使其支持具名管道。
- 修改文件系统与虚拟内存系统,使其支持内存映射文件。
第 9 章 再谈并发
在内核设计中,要同时拥有良好的并行性能、并发下的正确性,以及可理解的代码,是一项重大挑战。直接使用锁是达成正确性最可靠的方式,但这并非总是可行。本章会列出一些例子:有些情况 xv6 被迫以复杂的方式使用锁,也有些情况则采用了类锁的技巧,但实际上并没有使用锁。
9.1 加锁模式
被缓存的项目常常是加锁的一项难题。例如,文件系统的块缓存(kernel/bio.c:26)会保存最多 NBUF 个磁盘块的副本。必须确保同一个磁盘块在缓存中最多只有一份副本;否则,不同的进程可能会对本该是同一个块的不同副本做出相互冲突的修改。每个被缓存的块都保存在一个 struct buf(kernel/buf.h:1)中。struct buf 本身有一个 lock 字段,用来确保同一时间只有一个进程能使用某个磁盘块。然而,这把锁并不够用:假如某个块根本不在缓存中,而有两个进程同时想使用它,这时还没有对应的 struct buf 存在(因为该块尚未被缓存),所以无锁可加。xv6 通过为“目前已被缓存的块的身份集合”额外关联一把锁(bcache.lock)来处理这种情况。
任何需要检查某个块是否已被缓存(例如 bget,kernel/bio.c:59)或修改已缓存块集合的程序,都必须持有 bcache.lock;一旦找到所需的块与其对应的 struct buf,即可释放 bcache.lock,改为只锁住那个具体的块。这是一个常见的模式:一把锁保护整个集合,另一把锁保护集合中的个别项目。
一般来说,取得锁的函数会在同一个函数中释放该锁。但更精确的说法是:锁是在一段必须表现为原子的操作序列开始时被取得的,并在这段序列结束时被释放。如果这段序列的开始与结束发生在不同的函数、不同的线程,甚至不同的 CPU 上,那么锁的取得与释放也必须跨越这些边界。锁的作用是阻止其他使用者介入,而不是将数据绑定在某个特定的执行者上。一个例子是 yield 中的 acquire(kernel/proc.c:496),其对应的释放发生在 scheduler 线程中,而非原本发起取得的进程里。另一个例子是 ilock 中的 acquiresleep(kernel/fs.c:289):这段代码在读取磁盘时经常会睡眠,醒来时可能已经在另一个 CPU 上,因此 acquire 与 release 可能发生在不同的 CPU 上。
释放一个内部嵌有锁的对象是一件十分敏感的操作,因为单纯持有该锁并不足以保证释放行为是正确的。典型的问题是:当某个线程正等在 acquire 中、准备使用这个对象时,若此时另一个线程将该对象释放,那么这也会隐含地释放掉内嵌的锁本身,导致正在等待的线程出错。对此的一种解法是记录这个对象存在多少个引用(引用计数),只有当最后一个引用消失时才释放该对象。请参见 pipeclose(kernel/pipe.c:59)作为范例;其中 pi->readopen 与 pi->writeopen 用来追踪是否仍有文件描述符指向该管道。
void
pipeclose(struct pipe *pi, int writable)
{
  acquire(&pi->lock);
  if(writable){
    pi->writeopen = 0;
    wakeup(&pi->nread);
  } else {
    pi->readopen = 0;
    wakeup(&pi->nwrite);
  }
  if(pi->readopen == 0 && pi->writeopen == 0){
    release(&pi->lock);
    kfree((char*)pi);
  } else
    release(&pi->lock);
}
9.2 类锁模式
在 xv6 的许多地方,系统会以引用计数或标志的方式,用类似锁的手段表明某个对象处于已分配状态,因此不应该被释放或重新使用。进程的 p->state 就起着这样的作用,file、inode 与 buf 结构中的引用计数也是如此。虽然在每种情况下都有锁在保护该标志或引用计数,但真正防止对象被过早释放的,其实是标志或引用计数本身。
文件系统会把 struct inode 的引用计数当作一种可以由多个进程同时持有的共享锁,以此避免代码使用普通锁时可能发生的死锁。例如,namex 中的循环(kernel/fs.c:629)会依次对每个路径名成分所指向的目录加锁。
而 namex 必须在每轮循环结束时释放该锁,否则若它同时持有多个锁,一旦路径名中包含 .(例如 a/./b),就可能导致自身死锁;它也可能与另一个同时涉及该目录和 .. 的并发查找发生死锁。如第 8 章所解释的,解法是让循环把当前的目录 inode 带到下一轮——只增加引用计数而不加锁。
有些数据项在不同时期会受到不同机制的保护,有时甚至并非通过显式的锁,而是由 xv6 代码的结构隐式地避免并发访问。例如,当一个物理页处于空闲状态时,它会受到 kmem.lock(kernel/kalloc.c:24)的保护。若该页随后被分配给一个管道(kernel/pipe.c:23),它则会受到另一把锁(内嵌的 pi->lock)的保护。如果这个页被重新分配为某个新进程的用户内存,那它就完全不受任何锁保护了;保护它免遭并发访问的,是分配器的行为:只要该页尚未被释放,就不会被分配给其他进程。一个新进程内存的归属转移过程相当复杂:一开始由父进程在 fork 中分配并操作,然后由子进程使用,最后当子进程结束后,又回到父进程手上,并交由 kfree 释放。这里可以学到两点:第一,某个数据对象在其生命周期的不同阶段,可能会以不同方式受到并发保护;第二,这种保护有时可能是隐式的结构设计,而非显式地使用锁。
最后一个类锁的例子是:在调用 mycpu()(kernel/proc.c:80)时需要关闭中断。关闭中断可以让调用代码相对于时钟中断表现为原子操作,而时钟中断可能强行触发一次上下文切换,把进程移到另一个 CPU 上。
9.3 完全不用锁
在 xv6 中,有些地方会共享可变数据而完全不使用锁。其一是自旋锁的实现,不过你也可以认为 RISC-V 的原子指令依赖的是由硬件实现的锁。其二是 main.c 中的 started 变量(kernel/main.c:7),用来在 CPU 0 完成 xv6 的初始化之前阻止其他 CPU 开始运行;其中的 volatile 关键字可以确保编译器确实生成 load 与 store 指令。第三个例子是 p->killed:它在持有 p->lock 时被置位(kernel/proc.c:579),却在未持有任何锁的情况下被检查(kernel/trap.c:56)。
xv6 中存在这样的情形:一个 CPU 或线程写入某些数据,另一个 CPU 或线程则会读取这些数据,但却没有任何专门保护这些数据的锁。例如在 fork 中,父进程会写入子进程的用户内存页,而子进程(另一个线程,可能在另一个 CPU 上)会去读取这些页;这些页没有被任何锁显式地保护。
严格来说这不属于加锁问题,因为子进程是在父进程完成写入之后才开始执行的。不过这会形成一个潜在的内存顺序问题(详见第 6 章),因为在没有内存屏障的情况下,没有理由指望某个 CPU 能看到另一个 CPU 的写入。然而,由于父进程会释放锁,而子进程在启动时会取得锁,因此 acquire 与 release 中隐含的内存屏障可保证子进程所在的 CPU 能够看到父进程所写入的内容。
9.4 并行性
加锁的主要目的在于抑制并行性,以确保正确性。然而,性能同样也很重要,因此内核设计者往往必须思考如何在使用锁的同时,既能达到正确性,也能允许一定程度的并行性。虽然 xv6 并没有为高性能做系统性的设计,但仍然值得考虑哪些 xv6 操作能够并行运行、哪些操作可能在锁上发生冲突。
xv6 中的管道是一个并行性相当不错的例子。每个管道都有自己的锁,因此不同的进程可以在不同的 CPU 上并行地读写不同的管道。然而,对于同一个管道,写者与读者仍必须等待对方释放锁;它们不能同时对同一个管道进行读或写。此外,读取一个空管道(或写入一个已满的管道)也会被阻塞,不过这并非加锁方案造成的。
上下文切换是一个更复杂的例子。如果两个内核线程各自在自己的 CPU 上运行,可以同时调用 yield、sched 和 swtch,而这些调用能够并行执行。每个线程都持有一把锁,但这些锁彼此不同,因此它们不需互相等待。不过一旦进入 scheduler,这两个 CPU 就可能会在搜索进程表中处于 RUNNABLE 的进程时发生锁冲突。换句话说,xv6 在上下文切换期间很可能从多个 CPU 获得性能收益,但得到的提升可能不如它本可达到的那么多。
另一个例子是不同 CPU 上的不同进程同时调用 fork。这些调用可能需要互相等待,例如 pid_lock、kmem.lock,以及在进程表中搜索 UNUSED 进程时所要使用的每个进程自己的锁。但另一方面,这两个正在 fork 的进程也可以完全并行地拷贝用户内存页和格式化页表页。
上述各例中的加锁设计,在某些情况下都牺牲了一定的并行性能。而每一种情况其实都可以通过更精细的设计来提升并行性。至于是否值得这样做,则取决于许多细节:相关操作被调用的频率、代码持有存在竞争的锁时花费的时间、有多少个 CPU 可能同时运行相互冲突的操作,以及代码的其他部分是否是更严重的瓶颈。要判断某个加锁设计是否会造成性能问题,或一个新设计是否真的更好,往往并不容易,因此通常需要在真实负载下进行性能测量。
9.5 练习
- 修改 xv6 的管道实现,使同一个管道上的读与写可以在不同的 CPU 上并行进行。
- 修改 xv6 的
scheduler(),以减少不同 CPU 同时查找可运行进程时产生的锁竞争。 - 消除 xv6 的
fork()实现中的部分串行化。
第 10 章 总结
本书通过逐行研读一个操作系统——xv6——介绍了操作系统的主要思想。有些代码行体现了这些核心思想的精髓(例如上下文切换、用户/内核边界、锁等),每一行都很关键;另一些代码行则只是展示某种操作系统思想的某种具体实现方式,完全可以换用别的做法(例如更好的调度算法、更好的磁盘文件数据结构、支持并发事务的更好的日志机制等)。书中所有思想都是在一种特定的、非常成功的系统调用接口——Unix 接口——的语境中阐述的,但这些思想同样适用于其他操作系统的设计。
参考文献
- The RISC-V instruction set manual: privileged architecture. https://riscv.org/specifications/privileged-isa/, 2019.
- The RISC-V instruction set manual: user-level ISA. https://riscv.org/specifications/isa-spec-pdf/, 2019.
- Hans-J Boehm. Threads cannot be implemented as a library. ACM PLDI Conference, 2005.
- Edsger Dijkstra. Cooperating sequential processes. https://www.cs.utexas.edu/users/EWD/transcriptions/EWD01xx/EWD123.html, 1965.
- Maurice Herlihy and Nir Shavit. The Art of Multiprocessor Programming, Revised Reprint. 2012.
- Brian W. Kernighan. The C Programming Language. Prentice Hall Professional Technical Reference, 2nd edition, 1988.
- Gerwin Klein, Kevin Elphinstone, Gernot Heiser, June Andronick, David Cock, Philip Derrin, Dhammika Elkaduwe, Kai Engelhardt, Rafal Kolanski, Michael Norrish, Thomas Sewell, Harvey Tuch, and Simon Winwood. Sel4: Formal verification of an OS kernel. In Proceedings of the ACM SIGOPS 22nd Symposium on Operating Systems Principles, page 207–220, 2009.
- Donald Knuth. Fundamental Algorithms. The Art of Computer Programming. (Second ed.), volume 1. 1997.
- L Lamport. A new solution of dijkstra's concurrent programming problem. Communications of the ACM, 1974.
- John Lions. Commentary on UNIX 6th Edition. Peer to Peer Communications, 2000.
- Paul E. Mckenney, Silas Boyd-wickizer, and Jonathan Walpole. RCU usage in the linux kernel: One decade later, 2013.
- Martin Michael and Daniel Durich. The NS16550A: UART design and application considerations. http://bitsavers.trailing-edge.com/components/national/_appNotes/AN-0491.pdf, 1987.
- David Patterson and Andrew Waterman. The RISC-V Reader: an open architecture Atlas. Strawberry Canyon, 2017.
- Dave Presotto, Rob Pike, Ken Thompson, and Howard Trickey. Plan 9, a distributed system. In In Proceedings of the Spring 1991 EurOpen Conference, pages 43–50, 1991.
- Dennis M. Ritchie and Ken Thompson. The UNIX time-sharing system. Commun. ACM, 17(7):365–375, July 1974.